
এআই ডেটা সংগ্রহ: এটি কী এবং এটি কীভাবে কাজ করে
প্রক্রিয়া, পদ্ধতি, সর্বোত্তম অনুশীলন, সুবিধা, চ্যালেঞ্জ, খরচ, বাস্তব বিশ্বের উদাহরণ এবং সঠিক তথ্য সংগ্রহের অংশীদার কীভাবে নির্বাচন করবেন তা শিখুন।
ভূমিকা
কৃত্রিম বুদ্ধিমত্তা (এআই) এখন দৈনন্দিন কাজের একটি অংশ—যা চ্যাটবট, কো-পাইলট এবং টেক্সট, ছবি ও অডিও পরিচালনাকারী মাল্টিমোডাল টুলগুলোকে শক্তি জোগাচ্ছে। এর ব্যবহার দ্রুতগতিতে বাড়ছে: ম্যাককিনজির প্রতিবেদন অনুযায়ী , ৮৮% প্রতিষ্ঠান অন্তত একটি ব্যবসায়িক কার্যক্রমে এআই ব্যবহার করে । বাজারের প্রবৃদ্ধিও বাড়ছে; একটি হিসাব অনুযায়ী, ২০২৫ সালে এআই-এর বাজারমূল্য হবে প্রায় ৩৯০.৯ বিলিয়ন ডলার এবং ২০৩৩ সালের মধ্যে তা প্রায় ৩.৫ ট্রিলিয়ন ডলারে পৌঁছাবে বলে অনুমান করা হচ্ছে ।
প্রতিটি শক্তিশালী এআই সিস্টেমের পেছনে একই ভিত্তি রয়েছে: উচ্চ-মানের ডেটা । এই নির্দেশিকাটি ব্যাখ্যা করে যে কীভাবে সঠিক ডেটা সংগ্রহ করতে হয়, গুণমান ও নিয়মকানুন মেনে চলতে হয় এবং আপনার এআই প্রোজেক্টগুলোর জন্য সেরা পদ্ধতি (ইন-হাউস, আউটসোর্সড বা হাইব্রিড) বেছে নিতে হয়।
এআই ডেটা কালেকশন কী?
এআই ডেটা সংগ্রহ হল এমন ডেটাসেট তৈরির প্রক্রিয়া যা মডেল প্রশিক্ষণ এবং মূল্যায়নের জন্য প্রস্তুত - সঠিক সংকেত সংগ্রহ করে, সেগুলি পরিষ্কার এবং কাঠামোবদ্ধ করে, মেটাডেটা যুক্ত করে এবং প্রয়োজনে লেবেলিং করে। এটি কেবল "ডেটা পাওয়া" নয়। এটি নিশ্চিত করে যে ডেটা প্রাসঙ্গিক, নির্ভরযোগ্য, বাস্তব-বিশ্বে ব্যবহারের জন্য যথেষ্ট বৈচিত্র্যময় এবং পরে নিরীক্ষণের জন্য যথেষ্ট ভালভাবে নথিভুক্ত।
এআই প্রকল্পের জন্য সর্বাধিক সাধারণ ডেটা ফর্ম্যাট
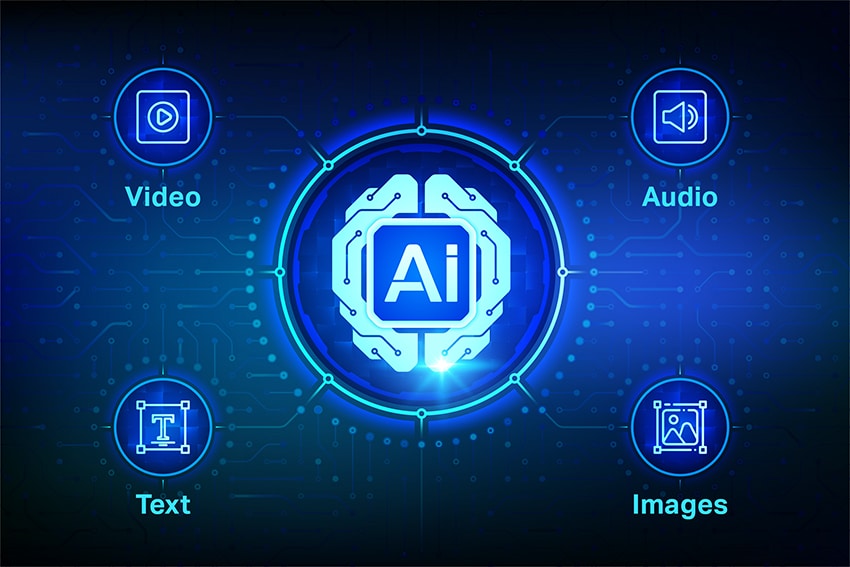
আপনার তৈরি করা সিস্টেমের উপর নির্ভর করে AI ডেটাসেটগুলি সাধারণত চারটি প্রধান বিভাগে পড়ে:
- পাঠ্য ডেটা: প্রশিক্ষণ তথ্যের সবচেয়ে বহুল ব্যবহৃত রূপগুলির মধ্যে একটি হল টেক্সট। এটি হতে পারে কাঠামোবদ্ধ (টেবিল, ডাটাবেস, সিআরএম রেকর্ড, ফর্ম) অথবা কাঠামোগত (ইমেল, চ্যাট লগ, জরিপ, নথি, সোশ্যাল মিডিয়া মন্তব্য)। এলএলএম এবং চ্যাটবটগুলির জন্য, টেক্সট ডেটাতে প্রায়শই জ্ঞান-ভিত্তিক নিবন্ধ, সহায়তা টিকিট এবং প্রশ্ন-উত্তর জোড়া অন্তর্ভুক্ত থাকে।
- অডিও ডেটা: অডিও ডেটা ভয়েস অ্যাসিস্ট্যান্ট, কল অ্যানালিটিক্স এবং ভয়েস-ভিত্তিক চ্যাটবটের মতো স্পিচ সিস্টেমগুলিকে প্রশিক্ষণ এবং উন্নত করতে সাহায্য করে। এই ডেটাসেটগুলি বাস্তব-বিশ্বের বৈচিত্র্য যেমন উচ্চারণ, উচ্চারণ, পটভূমির শব্দ এবং একই প্রশ্ন জিজ্ঞাসা করার বিভিন্ন উপায় ধারণ করে। সাধারণ উদাহরণগুলির মধ্যে রয়েছে কল সেন্টার রেকর্ডিং, ভয়েস কমান্ড এবং বহুভাষিক স্পিচ নমুনা।
- ছবি ডেটা: ইমেজ ডেটাসেটগুলি কম্পিউটার ভিশনকে শক্তি দেয় যেমন বস্তু সনাক্তকরণ, মেডিকেল ইমেজিং বিশ্লেষণ, খুচরা পণ্য স্বীকৃতি এবং আইডি যাচাইকরণ। ইমেজগুলিতে প্রায়শই ট্যাগ, বাউন্ডিং বক্স বা সেগমেন্টেশন মাস্কের মতো লেবেলের প্রয়োজন হয় যাতে মডেলরা কী দেখছে তা জানতে পারে।
- ভিডিও ডেটা: ভিডিও মূলত সময়ের সাথে সাথে ছবির একটি ধারাবাহিকতা, যা গতিবিধি এবং প্রেক্ষাপটের গভীর বোঝার জন্য এটিকে কার্যকর করে তোলে। ভিডিও ডেটাসেটগুলি স্বায়ত্তশাসিত ড্রাইভিং, নজরদারি বিশ্লেষণ, ক্রীড়া বিশ্লেষণ এবং শিল্প সুরক্ষা পর্যবেক্ষণের মতো অ্যাপ্লিকেশনগুলিকে সমর্থন করে - প্রায়শই ফ্রেম-বাই-ফ্রেম লেবেলিং বা ইভেন্ট ট্যাগিংয়ের প্রয়োজন হয়।
২০২৬ সালে এআই ডেটা সংগ্রহের ধরণ ভিন্ন হবে, কারণ অনেক সিস্টেমই এলএলএম চ্যাটবট, র্যাগ (রিট্রিভাল-অগমেন্টেড জেনারেশন) এবং মাল্টিমোডাল মডেল দ্বারা চালিত হবে । এর অর্থ হলো, দলগুলো সমান্তরালভাবে তিন ধরনের ডেটা সংগ্রহ করে: লার্নিং ডেটা (আচরণ শেখানোর জন্য), গ্রাউন্ডিং ডেটা (সঠিক উত্তরের জন্য র্যাগ-উপযোগী নথি), এবং ইভ্যালুয়েশন ডেটা (তথ্য পুনরুদ্ধারের নির্ভুলতা, হ্যালুসিনেশন এবং নীতির সামঞ্জস্য পরিমাপ করার জন্য)।
এআই ডেটা সংগ্রহ পদ্ধতির প্রকারভেদ
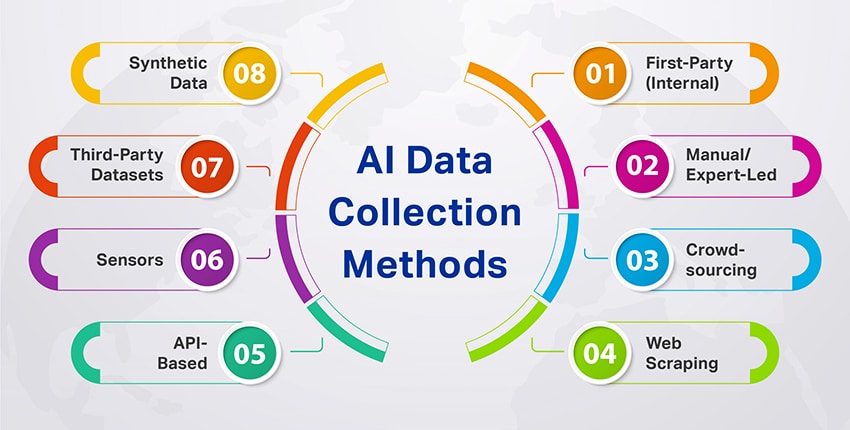
১. প্রথম পক্ষের (অভ্যন্তরীণ) তথ্য সংগ্রহ
আপনার নিজস্ব পণ্য, ব্যবহারকারী এবং ক্রিয়াকলাপ থেকে সংগৃহীত ডেটা—সাধারণত সবচেয়ে মূল্যবান কারণ এটি বাস্তব আচরণকে প্রতিফলিত করে।
উদাহরণ: একটি এলএলএম সাপোর্ট অ্যাসিস্ট্যান্টের কার্যকারিতা উন্নত করার জন্য, সম্মতি সাপেক্ষে সাপোর্ট টিকেট, সার্চ লগ এবং চ্যাটবট কথোপকথন এক্সপোর্ট করে সেগুলোকে ইস্যুর ধরন অনুযায়ী সাজানো।
2. ম্যানুয়াল/বিশেষজ্ঞের নেতৃত্বে সংগ্রহ
গভীর প্রেক্ষাপট, ক্ষেত্র জ্ঞান, অথবা উচ্চ নির্ভুলতার প্রয়োজন হলে মানুষ ইচ্ছাকৃতভাবে তথ্য সংগ্রহ বা তৈরি করে।
উদাহরণ: চিকিৎসকরা একটি স্বাস্থ্যসেবা এনএলপি মডেলকে প্রশিক্ষণ দেওয়ার জন্য মেডিকেল রিপোর্ট পর্যালোচনা করছেন এবং মূল তথ্যগুলো চিহ্নিত করছেন।
৪. ক্রাউডসোর্সিং (বিতরণকৃত মানব কর্মী)
দ্রুত স্কেলে ডেটা সংগ্রহ বা লেবেল করার জন্য বিশাল কর্মীদের ব্যবহার করা হচ্ছে। স্পষ্ট নির্দেশিকা, একাধিক পর্যালোচক এবং পরীক্ষার প্রশ্ন ব্যবহার করে গুণমান বজায় রাখা হচ্ছে।
উদাহরণস্বরূপ: স্পিচ রিকগনিশনের জন্য ক্রাউড কর্মীরা হাজার হাজার ছোট অডিও ক্লিপ ট্রান্সক্রাইব করে, এবং নির্ভুলতা যাচাই করার জন্য “গোল্ড” টেস্ট ক্লিপ ব্যবহার করে।
৫. ওয়েব ডেটা সংগ্রহ (স্ক্র্যাপিং)
পাবলিক ওয়েবসাইট থেকে স্বয়ংক্রিয়ভাবে তথ্য সংগ্রহ করা হচ্ছে (শুধুমাত্র যখন শর্তাবলী এবং আইন দ্বারা অনুমোদিত)। এই তথ্য প্রায়শই ব্যাপক পরিষ্কারের প্রয়োজন হয়।
উদাহরণ: প্রস্তুতকারকের পেজ থেকে পণ্যের সর্বজনীন স্পেসিফিকেশন সংগ্রহ করা এবং অগোছালো ওয়েব কন্টেন্টকে একটি প্রোডাক্ট-ম্যাচিং মডেলের জন্য সুসংগঠিত ফিল্ডে রূপান্তর করা।
৬. API-ভিত্তিক ডেটা সংগ্রহ
অফিসিয়াল API-এর মাধ্যমে ডেটা সংগ্রহ করা, যা সাধারণত স্ক্র্যাপিংয়ের চেয়ে বেশি সামঞ্জস্যপূর্ণ, নির্ভরযোগ্য এবং কাঠামোগত ডেটা সরবরাহ করে।
উদাহরণ: পূর্বাভাস বা অসঙ্গতি শনাক্তকরণের জন্য আর্থিক বাজারের এপিআই ব্যবহার করে মূল্য/সময়-ধারার ডেটা সংগ্রহ করা।
৭. সেন্সর এবং আইওটি ডেটা সংগ্রহ
ডিভাইস এবং সেন্সর (তাপমাত্রা, কম্পন, জিপিএস, ক্যামেরা, ইত্যাদি) থেকে ক্রমাগত স্ট্রিম ক্যাপচার করা, প্রায়শই রিয়েল-টাইম সিদ্ধান্তের জন্য।
উদাহরণ: কারখানার মেশিন থেকে কম্পন এবং তাপমাত্রার সংকেত সংগ্রহ করা, তারপর পূর্বাভাসমূলক রক্ষণাবেক্ষণের জন্য রক্ষণাবেক্ষণ লগগুলিকে লেবেল হিসাবে ব্যবহার করা।
৮. তৃতীয় পক্ষ/লাইসেন্সপ্রাপ্ত ডেটাসেট
উন্নয়ন দ্রুততর করতে বা কভারেজের ঘাটতি পূরণ করতে বিক্রেতা বা বাজার থেকে তৈরি ডেটাসেট কেনা বা লাইসেন্স দেওয়া।
উদাহরণস্বরূপ: একটি ভয়েস প্রোডাক্ট চালু করার জন্য একটি বহুভাষিক স্পিচ ডেটাসেটের লাইসেন্স নেওয়া, তারপর আপনার ব্যবহারকারীদের জন্য পারফরম্যান্স উন্নত করতে ফার্স্ট-পার্টি রেকর্ডিং যোগ করা।
8. সিন্থেটিক ডেটা জেনারেশন
গোপনীয়তার সীমাবদ্ধতা, বিরল ঘটনা, অথবা শ্রেণীগত ভারসাম্যহীনতা মোকাবেলা করার জন্য কৃত্রিম তথ্য তৈরি করা। বাস্তব-বিশ্বের ধরণগুলির সাথে কৃত্রিম তথ্য যাচাই করা উচিত।
উদাহরণ: প্রকৃত জালিয়াতির উদাহরণ সীমিত থাকলে, শনাক্তকরণ উন্নত করার জন্য বিরল জালিয়াতিপূর্ণ লেনদেনের ধরণ তৈরি করা।
কেন ডেটা কোয়ালিটি এআই সাফল্য নির্ধারণ করে
এআই শিল্প একটি পরিবর্তনশীল পর্যায়ে পৌঁছেছে: মৌলিক মডেল আর্কিটেকচারগুলি একত্রিত হচ্ছে, কিন্তু ডেটার গুণমান ব্যবহারকারীদের আনন্দ দেয় এমন পণ্য এবং তাদের হতাশ করে এমন পণ্যের মধ্যে প্রধান পার্থক্যকারী হিসেবে রয়ে গেছে।
খারাপ প্রশিক্ষণ তথ্যের খরচ
নিম্নমানের ডেটা মান এমনভাবে প্রকাশ পায় যা মডেলের কর্মক্ষমতার বাইরেও বিস্তৃত:
মডেলের ব্যর্থতা : অলীক কল্পনা, তথ্যগত ত্রুটি এবং বাচনভঙ্গির অসঙ্গতির মূল কারণ হলো প্রশিক্ষণ ডেটার ঘাটতি। অসম্পূর্ণ পণ্যের ডকুমেন্টেশনের উপর প্রশিক্ষিত একটি কাস্টমার সাপোর্ট চ্যাটবট আত্মবিশ্বাসের সাথে ভুল উত্তর দেবে।
সম্মতিগত ঝুঁকি : অনুমতি ছাড়া সংগৃহীত ডেটাসেট বা লাইসেন্সবিহীন কপিরাইটযুক্ত উপাদান ধারণকারী ডেটাসেট আইনি দায়বদ্ধতা তৈরি করে। ২০২৪-২০২৫ সালের একাধিক বহুল আলোচিত মামলা এটি প্রতিষ্ঠা করেছে যে, “আমরা জানতাম না” কোনো গ্রহণযোগ্য অজুহাত নয়।
পুনঃপ্রশিক্ষণের খরচ : ডেপ্লয়মেন্টের পরে ডেটার গুণগত মানের সমস্যা আবিষ্কৃত হলে তার জন্য ব্যয়বহুল পুনঃপ্রশিক্ষণ চক্রের প্রয়োজন হয় এবং রোডম্যাপ বাস্তবায়নে বিলম্ব ঘটে। এন্টারপ্রাইজ টিমগুলো জানায় যে, তারা এমএল প্রজেক্টের ৪০-৬০% সময় ডেটা প্রস্তুতি এবং সংশোধনের কাজে ব্যয় করে।
গুণমানের সংকেত খুঁজতে হবে
প্রশিক্ষণের তথ্য মূল্যায়ন করার সময়—সেটা বিক্রেতা থেকে হোক বা অভ্যন্তরীণ উৎস থেকে—এই মেট্রিক্সগুলি গুরুত্বপূর্ণ:
- জনসংখ্যাতাত্ত্বিক এবং ভাষাগত বৈচিত্র্য: বিশ্বব্যাপী স্থাপনার জন্য, ডেটা কি আপনার প্রকৃত ব্যবহারকারীর ভিত্তিকে প্রতিনিধিত্ব করে?
- টীকা গভীরতা: টীকাগুলি কি বাইনারি লেবেল নাকি সমৃদ্ধ, বহু-বৈশিষ্ট্যযুক্ত টীকাগুলি যা সূক্ষ্মতা ধারণ করে?
- লেবেলের ধারাবাহিকতা: একই জিনিস দুবার পর্যালোচনা করা হলে কি লেবেলগুলি সামঞ্জস্যপূর্ণ থাকে?
- এজ কেস কভারেজ: তথ্যে কি বিরল কিন্তু গুরুত্বপূর্ণ পরিস্থিতি অন্তর্ভুক্ত আছে, নাকি শুধুমাত্র "সুখী পথ"?
- সাময়িক প্রাসঙ্গিকতা: আপনার ডোমেনের জন্য কি বর্তমান তথ্য যথেষ্ট? আর্থিক বা সংবাদ-ভিত্তিক মডেলগুলির জন্য সাম্প্রতিক তথ্য প্রয়োজন।
তথ্য সংগ্রহ প্রক্রিয়া: প্রয়োজনীয়তা থেকে মডেল-প্রস্তুত ডেটাসেট পর্যন্ত
একটি স্কেলেবল এআই ডেটা সংগ্রহ প্রক্রিয়া পুনরাবৃত্তিযোগ্য, পরিমাপযোগ্য এবং সঙ্গতিপূর্ণ - কাঁচা ফাইলগুলির এককালীন ডাম্প নয়। বেশিরভাগ এআই/এমএল উদ্যোগের জন্য, চূড়ান্ত লক্ষ্য স্পষ্ট: একটি মেশিন-প্রস্তুত ডেটাসেট যা দলগুলি নির্ভরযোগ্যভাবে পুনঃব্যবহার, নিরীক্ষণ এবং সময়ের সাথে সাথে উন্নত করতে পারে।
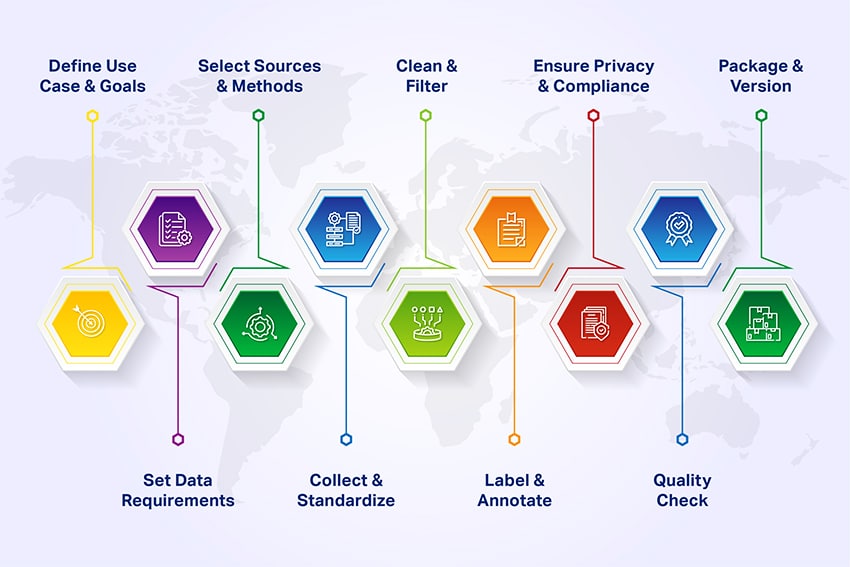
১. ব্যবহারের ধরণ এবং সাফল্যের মেট্রিক্স সংজ্ঞায়িত করুন
তথ্য নয়, ব্যবসায়িক সমস্যা দিয়ে শুরু করুন।
- এই মডেলটি কোন সমস্যার সমাধান করছে?
- উৎপাদনে সাফল্য কীভাবে পরিমাপ করা হবে?
উদাহরণ:
- "৬ মাসের মধ্যে ১৫% সহায়তা বৃদ্ধি কমিয়ে আনুন।"
- "শীর্ষ ৫০টি স্ব-পরিষেবা প্রশ্নের জন্য পুনরুদ্ধারের নির্ভুলতা উন্নত করুন।"
- "উৎপাদনে ত্রুটি সনাক্তকরণ প্রত্যাহার ১০% বৃদ্ধি করুন।"
এই লক্ষ্যগুলি পরবর্তীতে ডেটা ভলিউম, কভারেজ এবং মানের সীমা নির্ধারণ করে।
2. ডেটা প্রয়োজনীয়তা নির্দিষ্ট করুন
ব্যবহারের কেসটিকে নির্দিষ্ট ডেটা স্পেসিফিকেশনে অনুবাদ করুন।
- ডেটা প্রকার: টেক্সট, অডিও, ছবি, ভিডিও, ট্যাবুলার, অথবা মিশ্র
- ভলিউম রেঞ্জ: প্রাথমিক পাইলট বনাম সম্পূর্ণ রোলআউট (যেমন, 10K → 100K+ নমুনা)
- ভাষা এবং স্থান: বহুভাষিক, উচ্চারণ, উপভাষা, আঞ্চলিক বিন্যাস
- এনভায়রনমেন্ট: নীরব বনাম কোলাহলপূর্ণ, ক্লিনিকাল বনাম ভোক্তা, কারখানা বনাম অফিস
- এজ কেস: বিরল কিন্তু উচ্চ-প্রভাবশালী দৃশ্য যা আপনি মিস করতে পারবেন না
- ডেটা পরিসর: দেখতে একই রকম দশ হাজার রেকর্ডের পারফরম্যান্স, প্রোডাকশনে মডেলটির সম্মুখীন হতে যাওয়া বিভিন্ন পরিস্থিতি, জনসংখ্যাতাত্ত্বিক বৈশিষ্ট্য, ডকুমেন্টের ধরন এবং ব্যতিক্রমী পরিস্থিতি জুড়ে থাকা দুই হাজার রেকর্ডের তুলনায় খারাপ হবে।
এই "ডেটা প্রয়োজনীয়তার স্পেক" অভ্যন্তরীণ দল এবং বহিরাগত ডেটা বিক্রেতা উভয়ের জন্যই সত্যের একক উৎস হয়ে ওঠে।
৩. সংগ্রহ পদ্ধতি এবং উৎস নির্বাচন করুন
এই পর্যায়ে, আপনি সিদ্ধান্ত নেবেন যে আপনার ডেটা কোথা থেকে আসবে। সাধারণত, দলগুলি তিনটি প্রধান উৎস একত্রিত করে:
- বিনামূল্যে/পাবলিক ডেটাসেট: পরীক্ষা-নিরীক্ষা এবং বেঞ্চমার্কিংয়ের জন্য উপযোগী, কিন্তু প্রায়শই আপনার ডোমেন, লাইসেন্সিং চাহিদা বা সময়সীমার সাথে ভুলভাবে সামঞ্জস্যপূর্ণ।
- অভ্যন্তরীণ ডেটা: সিআরএম, সাপোর্ট টিকিট, লগ, মেডিকেল রেকর্ড, পণ্য ব্যবহারের ডেটা—অত্যন্ত প্রাসঙ্গিক, কিন্তু কাঁচা, বিরল বা সংবেদনশীল হতে পারে।
- প্রদত্ত/লাইসেন্সপ্রাপ্ত ডেটা বিক্রেতারা: যখন আপনার ডোমেন-নির্দিষ্ট, উচ্চ-মানের, টীকাযুক্ত এবং স্কেলে সঙ্গতিপূর্ণ ডেটাসেটের প্রয়োজন হয় তখন সবচেয়ে ভালো।
সর্বাধিক সফল প্রকল্পগুলিতে নিম্নলিখিতগুলি মিশ্রিত হয়:
- প্রোটোটাইপিংয়ের জন্য পাবলিক ডেটা ব্যবহার করুন।
- ডোমেনের প্রাসঙ্গিকতার জন্য অভ্যন্তরীণ ডেটা ব্যবহার করুন।
- অভ্যন্তরীণ দলগুলিকে অতিরিক্ত চাপ না দিয়ে যখন আপনার স্কেল, বৈচিত্র্য, সম্মতি এবং বিশেষজ্ঞ টীকা প্রয়োজন তখন Shaip-এর মতো বিক্রেতাদের ব্যবহার করুন।
কিছু পরিস্থিতিতে (যেমন, বিরল ঘটনা, নিয়ন্ত্রিত পরিবর্তন) সিন্থেটিক ডেটা বাস্তব-বিশ্বের ডেটার পরিপূরক হতে পারে, তবে এটি সম্পূর্ণরূপে বাস্তব ডেটা প্রতিস্থাপন করা উচিত নয়।
৪. তথ্য সংগ্রহ এবং মানসম্মতকরণ
তথ্য প্রবাহিত হতে শুরু করলে, মানসম্মতকরণ পরবর্তীতে বিশৃঙ্খলা রোধ করে।
- সামঞ্জস্যপূর্ণ ফাইল ফর্ম্যাট প্রয়োগ করুন (যেমন, অডিওর জন্য WAV, মেটাডেটার জন্য JSON, ইমেজিংয়ের জন্য DICOM)।
- সমৃদ্ধ মেটাডেটা ক্যাপচার করুন: তারিখ/সময়, লোকেল, ডিভাইস, চ্যানেল, পরিবেশ, সম্মতির স্থিতি এবং উৎস।
- স্কিমা এবং অন্টোলজির উপর সারিবদ্ধ করুন: কীভাবে লেবেল, ক্লাস, ইন্টেন্ট এবং সত্তার নামকরণ এবং কাঠামো তৈরি করা হয়।
এখানেই একজন ভালো বিক্রেতা আপনার পছন্দের স্কিমায় ডেটা সরবরাহ করবে, আপনার টিমের কাছে কাঁচা, ভিন্নধর্মী ফাইল পাঠানোর পরিবর্তে।
৫. পরিষ্কার এবং ফিল্টার করুন
কাঁচা তথ্য অগোছালো। পরিষ্কার করার মাধ্যমে কেবল দরকারী, ব্যবহারযোগ্য এবং আইনি তথ্যই এগিয়ে যায়।
সাধারণ কর্মকাণ্ডের মধ্যে রয়েছে:
- ডুপ্লিকেট এবং প্রায়-ডুপ্লিকেট অপসারণ করা হচ্ছে
- দূষিত, নিম্নমানের, অথবা অসম্পূর্ণ নমুনা বাদ দেওয়া
- সুযোগের বাইরের কন্টেন্ট ফিল্টার করা (ভুল ভাষা, ভুল ডোমেইন, ভুল উদ্দেশ্য)
- বিন্যাস স্বাভাবিককরণ (টেক্সট এনকোডিং, নমুনা হার, রেজোলিউশন)
অভ্যন্তরীণ দলগুলি প্রায়শই পরিষ্কার-পরিচ্ছন্নতার প্রচেষ্টাকে অবমূল্যায়ন করে। এই পদক্ষেপটি একটি বিশেষায়িত সরবরাহকারীর কাছে আউটসোর্সিং করলে বাজারের সময় উল্লেখযোগ্যভাবে হ্রাস পেতে পারে।
৬. লেবেল এবং টীকা (প্রয়োজনে)
তত্ত্বাবধানে থাকা এবং মানুষের সাথে সংযুক্ত সিস্টেমের জন্য সামঞ্জস্যপূর্ণ, উচ্চ-মানের লেবেল প্রয়োজন।
ব্যবহারের ক্ষেত্রের উপর নির্ভর করে, এতে অন্তর্ভুক্ত থাকতে পারে:
- চ্যাটবট এবং ভার্চুয়াল সহকারীর জন্য উদ্দেশ্য এবং সত্তা
- বক্তৃতা এবং কল বিশ্লেষণের জন্য ট্রান্সক্রিপ্ট এবং স্পিকার লেবেল
- কম্পিউটার দৃষ্টিভঙ্গির জন্য বাউন্ডিং বক্স, বহুভুজ, অথবা সেগমেন্টেশন মাস্ক
- অনুসন্ধান এবং RAG সিস্টেমের জন্য প্রাসঙ্গিকতা বিচার এবং র্যাঙ্কিং লেবেল
- স্বাস্থ্যসেবা NLP-এর জন্য ICD কোড, ওষুধ এবং ক্লিনিকাল ধারণা
সাফল্যের মূল কারণগুলি:
- স্পষ্ট, বিস্তারিত টীকা নির্দেশিকা
- টীকাকারদের প্রশিক্ষণ এবং বিষয় বিশেষজ্ঞদের সাথে যোগাযোগের সুযোগ
- অস্পষ্ট মামলার জন্য ঐক্যমত্যের নিয়ম
- ধারাবাহিকতা ট্র্যাক করার জন্য আন্তঃ-টীকাকার চুক্তির পরিমাপ
স্বাস্থ্যসেবা বা অর্থের মতো বিশেষায়িত ক্ষেত্রে, জেনেরিক ক্রাউড অ্যানোটেশন যথেষ্ট নয়। আপনার এসএমই এবং নিরীক্ষিত কর্মপ্রবাহের প্রয়োজন - ঠিক যেখানে শাইপের মতো একজন অংশীদার মূল্য নিয়ে আসে।
৭. গোপনীয়তা, নিরাপত্তা এবং সম্মতি নিয়ন্ত্রণ প্রয়োগ করুন
প্রথম দিন থেকেই তথ্য সংগ্রহকে নিয়ন্ত্রক এবং নীতিগত সীমানা মেনে চলতে হবে।
সাধারণ নিয়ন্ত্রণগুলির মধ্যে রয়েছে:
- ব্যক্তিগত এবং সংবেদনশীল তথ্যের শনাক্তকরণ/অজ্ঞাতনামা বাতিল করা
- সম্মতি ট্র্যাকিং এবং ডেটা ব্যবহারের সীমাবদ্ধতা
- ধরে রাখা এবং মুছে ফেলার নীতি
- ভূমিকা-ভিত্তিক অ্যাক্সেস নিয়ন্ত্রণ এবং ডেটা এনক্রিপশন
- GDPR, HIPAA, CCPA, এবং শিল্প-নির্দিষ্ট নিয়মের মতো মান মেনে চলা
একজন অভিজ্ঞ ডেটা পার্টনার এই প্রয়োজনীয়তাগুলিকে সংগ্রহ, টীকা, বিতরণ এবং সংরক্ষণের ক্ষেত্রে ব্যবহার করবেন, এগুলিকে কেবল একটি চিন্তাভাবনা হিসেবে বিবেচনা করবেন না।
৮. গুণমান নিশ্চিতকরণ এবং গ্রহণযোগ্যতা পরীক্ষা
একটি ডেটাসেটকে "মডেল-প্রস্তুত" ঘোষণা করার আগে, এটিকে কাঠামোগত QA এর মধ্য দিয়ে যেতে হবে।
সাধারণ অভ্যাস:
- নমুনা সংগ্রহ এবং নিরীক্ষা: প্রতিটি ব্যাচ থেকে এলোমেলো নমুনার মানব পর্যালোচনা
- সোনার সেট: একটি ছোট, বিশেষজ্ঞ-লেবেলযুক্ত রেফারেন্স সেট যা টীকাকারের কর্মক্ষমতা মূল্যায়ন করতে ব্যবহৃত হয়।
- ত্রুটি ট্র্যাকিং: সমস্যার শ্রেণীবিভাগ (ভুল লেবেল, অনুপস্থিত লেবেল, বিন্যাস ত্রুটি, পক্ষপাত, ইত্যাদি)
- গ্রহণযোগ্যতার মানদণ্ড: নির্ভুলতা, কভারেজ এবং ধারাবাহিকতার জন্য পূর্ব-নির্ধারিত থ্রেশহোল্ড
যখন কোনও ডেটাসেট এই মানদণ্ডগুলি পূরণ করে কেবল তখনই এটি প্রশিক্ষণ, বৈধতা বা মূল্যায়নের জন্য উন্নীত করা উচিত।
৯. পুনঃব্যবহারের জন্য প্যাকেজ, ডকুমেন্ট এবং সংস্করণ
পরিশেষে, তথ্য আজ ব্যবহারযোগ্য এবং আগামীকাল পুনরুৎপাদনযোগ্য হতে হবে।
সেরা অনুশীলন:
- স্পষ্ট স্কিমা, লেবেল ট্যাক্সোনমি এবং মেটাডেটা সংজ্ঞা সহ প্যাকেজ ডেটা
- ডকুমেন্টেশন অন্তর্ভুক্ত করুন: তথ্য উৎস, সংগ্রহ পদ্ধতি, জ্ঞাত সীমাবদ্ধতা এবং উদ্দেশ্যপ্রণোদিত ব্যবহার।
- সংস্করণ ডেটাসেট যাতে দলগুলি ট্র্যাক করতে পারে কোন সংস্করণটি কোন মডেল, পরীক্ষা বা প্রকাশের জন্য ব্যবহৃত হয়েছিল।
- ছায়া ডেটাসেট এবং ডুপ্লিকেট প্রচেষ্টা এড়াতে ডেটাসেটগুলিকে অভ্যন্তরীণভাবে (এবং নিরাপদে) আবিষ্কারযোগ্য করে তুলুন।
ইন-হাউস বনাম আউটসোর্স বনাম হাইব্রিড: আপনার কোন মডেলটি বেছে নেওয়া উচিত?
বেশিরভাগ দলই চিরস্থায়ীভাবে শুধু একটি পদ্ধতি বেছে নেয় না। সেরা মডেলটি নির্ভর করে ডেটার সংবেদনশীলতা, গতি, পরিধি এবং আপনার ডেটাসেট কত ঘন ঘন আপডেট করা প্রয়োজন তার উপর (বিশেষ করে RAG এবং প্রোডাকশন চ্যাটবটের ক্ষেত্রে এটি বিশেষভাবে সত্য)।
| মডেল | এর মানে কি | সবচেয়ে ভালো যখন | বাণিজ্য বন্ধ | ২০২৬ সালের সাধারণ বাস্তবতা |
|---|---|---|---|---|
| আভ্যন্তরীণ | আপনার দল সোর্সিং, সংগ্রহ, QA এবং প্রায়শই লেবেলিং পরিচালনা করে। | ডেটা অত্যন্ত সংবেদনশীল, কর্মপ্রবাহ অনন্য, এবং শক্তিশালী অভ্যন্তরীণ ক্রিয়াকলাপ বিদ্যমান। | নিয়োগ এবং সরঞ্জাম তৈরিতে সময় লাগে; স্কেলিং কঠিন; QA একটি বাধা হয়ে দাঁড়াতে পারে। | স্থির ভলিউম এবং কঠোর শাসনের চাহিদা সহ পরিণত দলগুলির জন্য কাজ করে। |
| আউটসোর্স | বিক্রেতা সংগ্রহ, লেবেলিং এবং QA এন্ড-টু-এন্ড পরিচালনা করে। | আপনার গতি, বিশ্বব্যাপী স্কেল, বহুভাষিক কভারেজ, অথবা বিশেষায়িত তথ্য সংগ্রহের প্রয়োজন। | শক্তিশালী স্পেসিফিকেশন এবং বিক্রেতা ব্যবস্থাপনা প্রয়োজন; শাসনব্যবস্থা স্পষ্ট হতে হবে। | একটি বৃহৎ অভ্যন্তরীণ দল তৈরি না করেই পাইলট এবং দ্রুত স্কেলিং এর জন্য আদর্শ। |
| অকুলীন | সংবেদনশীল কৌশল এবং শাসনব্যবস্থা অভ্যন্তরীণভাবে পরিচালিত হয়; বাস্তবায়ন এবং স্কেল আউটসোর্স করা হয়। | আপনি নিয়ন্ত্রণ এবং গতি চান, ঘন ঘন রিফ্রেশ প্রয়োজন, এবং সম্মতির সীমাবদ্ধতা রয়েছে। | স্পেসিফিকেশন, গ্রহণযোগ্যতার মানদণ্ড এবং সংস্করণ জুড়ে স্পষ্ট হ্যান্ডঅফ প্রয়োজন। | এলএলএম এবং আরএজি প্রোগ্রামের জন্য সবচেয়ে সাধারণ এন্টারপ্রাইজ সেটআপ। |
তথ্য সংগ্রহের চ্যালেঞ্জ
বেশিরভাগ ব্যর্থতাই আসে পূর্বাভাসযোগ্য চ্যালেঞ্জ থেকে। এইসবের জন্য আগে থেকেই পরিকল্পনা করুন:
- প্রাসঙ্গিকতার ফাঁক: ডেটা বিদ্যমান, কিন্তু এটি আপনার আসল ব্যবহারের ক্ষেত্রে মেলে না (ভুল ডোমেন, ভুল ব্যবহারকারীর উদ্দেশ্য, পুরানো সামগ্রী)।
- কভারেজ ফাঁক: ভাষা, উচ্চারণ, জনসংখ্যা, ডিভাইস, পরিবেশ, অথবা "বিরল কিন্তু গুরুত্বপূর্ণ" পরিস্থিতি অনুপস্থিত।
- পক্ষপাত: ডেটাসেটটি নির্দিষ্ট কিছু গোষ্ঠী বা শর্তকে অতিরিক্ত উপস্থাপন করে, যা কম প্রতিনিধিত্বকারী ব্যবহারকারীদের জন্য অন্যায্য বা ভুল আউটপুট তৈরি করতে পারে।
- গোপনীয়তা এবং সম্মতির ঝুঁকি: বিশেষ করে চ্যাট, ভয়েস, স্বাস্থ্যসেবা এবং আর্থিক তথ্যের ক্ষেত্রে—যেখানে সংবেদনশীল তথ্য উপস্থিত হতে পারে।
- উৎপত্তি এবং লাইসেন্সিং অনিশ্চয়তা: টিমগুলি এমন ডেটা সংগ্রহ করে যা তারা আইনত পুনঃব্যবহার, ভাগাভাগি বা স্কেলে স্থাপন করতে পারে না।
- স্কেল এবং টাইমলাইন চাপ: পাইলটরা সফল হয়, তারপর ভলিউম বৃদ্ধি পেলে এবং QA তাল মিলিয়ে চলতে না পারলে মান কমে যায়।
- অনুপস্থিত প্রতিক্রিয়া লুপ: উৎপাদন পর্যবেক্ষণ ছাড়া, ডেটাসেট বাস্তবতার সাথে মিল বন্ধ করে দেয় (নতুন উদ্দেশ্য, নতুন নীতি, নতুন প্রান্তিক কেস)।
তথ্য সংগ্রহের সুবিধা
এই সমস্যার একটি নির্ভরযোগ্য সমাধান রয়েছে এবং আপনার এআই মডেলগুলির জন্য প্রশিক্ষণ ডেটা অর্জনের আরও ভাল এবং কম ব্যয়বহুল উপায় রয়েছে। আমরা তাদের প্রশিক্ষণ ডেটা পরিষেবা প্রদানকারী বা ডেটা বিক্রেতা বলি।
তারা Shaip এর মতো ব্যবসা যা আপনার অনন্য চাহিদা এবং প্রয়োজনীয়তার উপর ভিত্তি করে উচ্চমানের ডেটাসেট সরবরাহে বিশেষজ্ঞ। তারা প্রাসঙ্গিক ডেটাসেটগুলি সোর্স করা, পরিষ্কার করা, সংকলন করা এবং টীকা দেওয়া এবং আরও অনেক কিছুতে ডেটা সংগ্রহের ক্ষেত্রে আপনার যে সমস্ত ঝামেলার মুখোমুখি হতে হয় তা দূর করে এবং আপনাকে কেবল আপনার AI মডেল এবং অ্যালগরিদমগুলিকে অপ্টিমাইজ করার উপর মনোনিবেশ করতে দেয়। ডেটা বিক্রেতাদের সাথে সহযোগিতা করে, আপনি গুরুত্বপূর্ণ বিষয়গুলিতে এবং আপনার নিয়ন্ত্রণে থাকা বিষয়গুলিতে মনোনিবেশ করেন।
এছাড়াও, আপনি বিনামূল্যে এবং অভ্যন্তরীণ সংস্থান থেকে ডেটাসেট সংগ্রহের সাথে সম্পর্কিত সমস্ত ঝামেলাও দূর করবেন। একটি এন্ড-টু-এন্ড ডেটা প্রদানকারীর সুবিধাগুলি সম্পর্কে আপনাকে আরও ভাল ধারণা দেওয়ার জন্য, এখানে একটি সংক্ষিপ্ত তালিকা দেওয়া হল:
যখন তথ্য সংগ্রহ সঠিকভাবে করা হয়, তখন ফলাফল মডেল মেট্রিক্সের বাইরেও দেখা যায়:
- উচ্চতর মডেল নির্ভরযোগ্যতা: উৎপাদনে কম চমক এবং আরও ভালো সাধারণীকরণ।
- দ্রুত পুনরাবৃত্তি চক্র: পরিষ্কার এবং পুনরায় লেবেলিংয়ে কম পুনর্গঠন।
- আরও বিশ্বস্ত LLM অ্যাপ: ভালো গ্রাউন্ডিং, কম হ্যালুসিনেশন, নিরাপদ প্রতিক্রিয়া।
- দীর্ঘমেয়াদী খরচ কম: গুণমান আগেভাগে ব্যয়বহুল ডাউনস্ট্রিম সংশোধন প্রতিরোধ করে।
- উন্নত সম্মতি ভঙ্গি: স্পষ্ট ডকুমেন্টেশন, অডিট ট্রেইল এবং নিয়ন্ত্রিত অ্যাক্সেস।
বাস্তব জগতে AI ডেটা সংগ্রহের বাস্তব উদাহরণ

উদাহরণ ১: গ্রাহক সহায়তা LLM চ্যাটবট (RAG + মূল্যায়ন)
- উদ্দেশ্য: টিকিটের পরিমাণ কমানো এবং স্ব-পরিষেবা রেজোলিউশন উন্নত করা।
- উপাত্ত: কিউরেটেড সহায়তা কেন্দ্রের নিবন্ধ, পণ্যের ডকুমেন্টেশন এবং বেনামী সমাধান করা টিকিট।
- অতিরিক্ত: RAG মান পরিমাপের জন্য একটি কাঠামোগত পুনরুদ্ধার মূল্যায়ন সেট (ব্যবহারকারীর প্রশ্ন → সঠিক উৎস নথি)।
- অভিগমন: অভ্যন্তরীণ নথিগুলিকে বিক্রেতা-সমর্থিত টীকা সহ একত্রিত করে উদ্দেশ্যগুলি লেবেল করা, প্রশ্নগুলির উত্তর ম্যাপ করা এবং পুনরুদ্ধারের প্রাসঙ্গিকতা মূল্যায়ন করা।
- ফলাফল: আরও ভিত্তিগত উত্তর, হ্রাসকৃত বৃদ্ধি এবং গ্রাহক সন্তুষ্টিতে পরিমাপযোগ্য উন্নতি।
উদাহরণ ২: ভয়েস সহকারীদের জন্য স্পিচ এআই
- উদ্দেশ্য: বাজার, উচ্চারণ এবং পরিবেশ জুড়ে বক্তৃতা স্বীকৃতি উন্নত করুন।
- উপাত্ত: বিভিন্ন বক্তা, পরিবেশ (শান্ত ঘর, ব্যস্ত রাস্তা, গাড়ি) এবং ডিভাইস থেকে হাজার হাজার ঘন্টার বক্তৃতা।
- অতিরিক্ত: উচ্চারণ এবং ভাষা কভারেজ পরিকল্পনা, মানসম্মত ট্রান্সক্রিপশন নিয়ম, এবং স্পিকার/লোকেল মেটাডেটা।
- অভিগমন: বিশ্বব্যাপী অংশগ্রহণকারীদের নিয়োগ, স্ক্রিপ্টেড এবং আনস্ক্রিপ্টেড কমান্ড রেকর্ড এবং সম্পূর্ণরূপে প্রতিলিপিকৃত, টীকাযুক্ত এবং মান-পরীক্ষিত কর্পোরা প্রদানের জন্য একটি বক্তৃতা ডেটা সরবরাহকারীর সাথে অংশীদারিত্ব করা হয়েছে।
- ফল: বাস্তব জগতের পরিস্থিতিতে উচ্চতর শনাক্তকরণ নির্ভুলতা এবং অ-মানক উচ্চারণ ব্যবহারকারীদের জন্য উন্নত কর্মক্ষমতা।
উদাহরণ ৩: স্বাস্থ্যসেবা NLP (গোপনীয়তা-প্রথম)
- উদ্দেশ্য: ক্লিনিকাল সিদ্ধান্ত গ্রহণকে সমর্থন করার জন্য অসংগঠিত নোট থেকে ক্লিনিকাল ধারণাগুলি বের করুন।
- উপাত্ত: অ-শনাক্তকৃত ক্লিনিকাল নোট এবং প্রতিবেদন, অবস্থা, ওষুধ, পদ্ধতি এবং ল্যাব মানের জন্য SME-পর্যালোচিত লেবেল দিয়ে সমৃদ্ধ।
- অতিরিক্ত: কঠোর অ্যাক্সেস নিয়ন্ত্রণ, এনক্রিপশন এবং অডিট লগগুলি HIPAA এবং হাসপাতালের নীতির সাথে সামঞ্জস্যপূর্ণ।
- অভিগমন: ডি-আইডেন্টিফিকেশন, টার্মিনোলজি ম্যাপিং এবং ডোমেন বিশেষজ্ঞ টীকা পরিচালনা করার জন্য একটি বিশেষায়িত স্বাস্থ্যসেবা ডেটা বিক্রেতা ব্যবহার করা হয়েছে, যা হাসপাতালের আইটি এবং ক্লিনিকাল কর্মীদের উপর বোঝা কমিয়েছে।
- ফল: উচ্চমানের ক্লিনিকাল সিগন্যাল সহ নিরাপদ মডেল, PHI প্রকাশ না করে বা সম্মতির সাথে আপস না করে মোতায়েন করা হয়েছে।
উদাহরণ ৪: উৎপাদনে কম্পিউটার দৃষ্টিভঙ্গি
- উদ্দেশ্য: উৎপাদন লাইনে স্বয়ংক্রিয়ভাবে ত্রুটি সনাক্ত করুন।
- উপাত্ত: বিভিন্ন শিফট, আলোর অবস্থা, ক্যামেরার কোণ এবং পণ্যের ধরণ জুড়ে কারখানার ছবি এবং ভিডিও।
- অতিরিক্ত: ত্রুটির ধরণগুলির জন্য একটি স্পষ্ট অন্টোলজি এবং QA এবং মডেল মূল্যায়নের জন্য একটি সোনার সেট।
- অভিগমন: "স্বাভাবিক" এবং "ত্রুটিপূর্ণ" উভয় পণ্যের উপর দৃষ্টি নিবদ্ধ করে বিভিন্ন ভিজ্যুয়াল ডেটা সংগ্রহ এবং টীকাবদ্ধ করা হয়েছে, যার মধ্যে বিরল কিন্তু গুরুতর ত্রুটির ধরণও রয়েছে।
- ফল: ত্রুটি সনাক্তকরণে কম মিথ্যা ইতিবাচক এবং মিথ্যা নেতিবাচক, আরও নির্ভরযোগ্য অটোমেশন সক্ষম করে এবং ম্যানুয়াল পরিদর্শন প্রচেষ্টা হ্রাস করে।
এআই ডেটা সংগ্রহ বিক্রেতাদের কীভাবে মূল্যায়ন করবেন
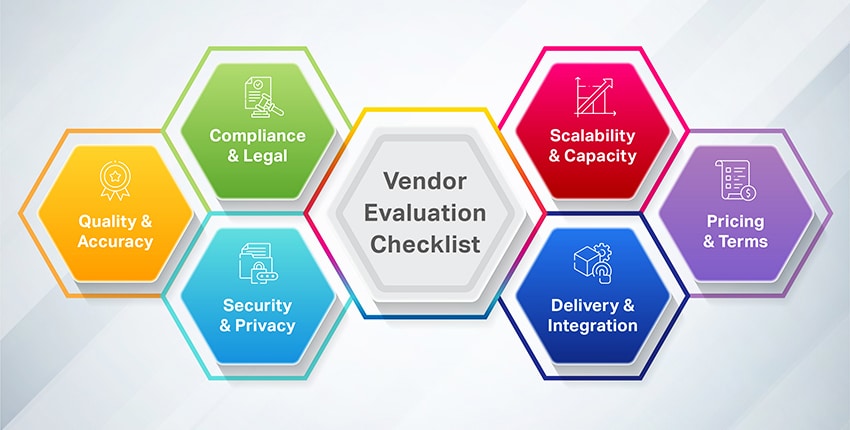
বিক্রেতা মূল্যায়ন চেকলিস্ট
বিক্রেতা মূল্যায়নের সময় এই চেকলিস্টটি ব্যবহার করুন:
গুণমান এবং নির্ভুলতা
- নথিভুক্ত মান নিশ্চিতকরণ প্রক্রিয়া (বহু-স্তরীয় পর্যালোচনা, স্বয়ংক্রিয় পরীক্ষা)
- আন্তঃ-টীকাকার চুক্তির মেট্রিক্স উপলব্ধ
- ত্রুটি সংশোধন এবং প্রতিক্রিয়া লুপ প্রক্রিয়া
- প্রতিশ্রুতি দেওয়ার আগে নমুনা ডেটা পর্যালোচনা
সম্মতি এবং আইনী
- ডেটার উৎপত্তিস্থলের ডকুমেন্টেশন পরিষ্কার করুন
- তথ্য বিষয়ের জন্য সম্মতি প্রক্রিয়া
- জিডিপিআর, সিসিপিএ এবং প্রাসঙ্গিক আঞ্চলিক সম্মতি
- ডেটা লাইসেন্সিং শর্তাবলী যা আপনার উদ্দেশ্যপ্রণোদিত ব্যবহারকে অন্তর্ভুক্ত করে
- ডেটা আইপি সমস্যার জন্য ক্ষতিপূরণ ধারা
সুরক্ষা ও গোপনীয়তা
- SOC 2 টাইপ II সার্টিফিকেশন (অথবা সমতুল্য)
- বিশ্রামে এবং ট্রানজিটে ডেটা এনক্রিপশন
- অ্যাক্সেস নিয়ন্ত্রণ এবং অডিট লগিং
- শনাক্তকরণ বিচ্ছিন্নকরণ এবং PII পরিচালনা পদ্ধতি
- ডেটা ধরে রাখা এবং মুছে ফেলার নীতি
স্কেলেবিলিটি এবং ক্ষমতা
- আপনার প্রয়োজনীয় স্কেলে প্রমাণিত ট্র্যাক রেকর্ড
- সময়-সংবেদনশীল প্রকল্পগুলির জন্য ক্ষমতা বৃদ্ধি
- বহু-ভাষা এবং বহু-অঞ্চল ক্ষমতা
- আপনার লক্ষ্য ডোমেনে কর্মীবাহিনীর গভীরতা
ডেলিভারি এবং ইন্টিগ্রেশন
- API অ্যাক্সেস বা স্বয়ংক্রিয় ডেলিভারি বিকল্পগুলি
- আপনার ML পাইপলাইনের সাথে সামঞ্জস্য (ফরম্যাট, স্কিমা)
- প্রতিকার পদ্ধতি সহ SLA পরিষ্কার করুন
- স্বচ্ছ প্রকল্প ব্যবস্থাপনা এবং যোগাযোগ
মূল্য এবং শর্তাবলী
- স্বচ্ছ মূল্য নির্ধারণ মডেল (প্রতি-ইউনিট, প্রতি-ঘণ্টা, প্রকল্প-ভিত্তিক)
- সংশোধন, ফর্ম্যাট পরিবর্তন, বা তাড়াহুড়ো ডেলিভারির জন্য কোনও লুকানো ফি নেই
- নমনীয় চুক্তির শর্তাবলী (পাইলট বিকল্প, স্কেলেবল প্রতিশ্রুতি)
- ডেলিভারেবলের স্পষ্ট মালিকানা
বিক্রেতা স্কোরিং রুব্রিক
পদ্ধতিগতভাবে বিক্রেতাদের তুলনা করতে এই টেমপ্লেটটি ব্যবহার করুন:
| নির্ণায়ক | ওজন | বিক্রেতা A (১-৫) | বিক্রেতা খ (১-৫) | বিক্রেতা গ (১-৫) |
|---|---|---|---|---|
| গুণমান নিশ্চিতকরণ প্রক্রিয়া | ৮০% | |||
| সম্মতি এবং উৎপত্তি | ৮০% | |||
| নিরাপত্তা সার্টিফিকেশন | ৮০% | |||
| স্কেলেবিলিটি এবং ক্ষমতা | ৮০% | |||
| ডোমেন দক্ষতা | ৮০% | |||
| মূল্য নির্ধারণের স্বচ্ছতা | ৮০% | |||
| ডেলিভারি এবং ইন্টিগ্রেশন | ৮০% | |||
| ওজনযুক্ত মোট | ৮০% |
স্কোরিং গাইড:
৫ = প্রয়োজনীয়তা অতিক্রম করে, স্পষ্ট শিল্প নেতৃত্ব;
৪ = দৃঢ় প্রমাণ সহ প্রয়োজনীয়তা সম্পূর্ণরূপে পূরণ করে;
৩ = পর্যাপ্তভাবে প্রয়োজনীয়তা পূরণ করে;
২ = আংশিকভাবে প্রয়োজনীয়তা পূরণ করে, ফাঁকগুলি চিহ্নিত করা হয়েছে;
১ = প্রয়োজনীয়তা পূরণ করে না।
দাম জিজ্ঞাসা করার আগে পণ্যের মান নির্ধারণ করুন।
অ্যানোটেশনের গুণমান কোনো একটি সংখ্যা দিয়ে পরিমাপ করা যায় না। লেবেল ক্লাস অনুযায়ী অ্যানোটেটরদের মধ্যে লক্ষ্যমাত্রার পারস্পরিক সম্মতি, মতবিরোধের নিষ্পত্তি প্রক্রিয়া, নির্ধারিত গোল্ড-স্ট্যান্ডার্ড এবং কে তা তৈরি করবে, QA স্যাম্পলিং রেট, যেখানে কাজের জন্য ডোমেইন দক্ষতার প্রয়োজন সেখানে রিভিউয়ারের যোগ্যতার আবশ্যকতা, এবং কোনো ব্যাচ ব্যর্থ হলে প্রতিকার নীতি নির্দিষ্ট করে দিন। এই বিষয়গুলো নির্দিষ্ট করার আগে কোনো বিক্রেতা যদি মূল্য উল্লেখ করে, তবে সে আপনার চালানো প্রকল্পের চেয়ে ভিন্ন কোনো প্রকল্পের জন্য মূল্য দিচ্ছে।
ক্রেতাদের সাধারণ প্রশ্ন (Reddit, Quora, এবং Enterprise RFP কল থেকে)
এই প্রশ্নগুলি শিল্প ফোরাম এবং এন্টারপ্রাইজ ক্রয় আলোচনার সাধারণ বিষয়গুলি প্রতিফলিত করে।
"এআই প্রশিক্ষণের ডেটার দাম কত?"
ডেটার ধরণ, মানের স্তর এবং স্কেল অনুসারে মূল্য নাটকীয়ভাবে পরিবর্তিত হয়। সহজ লেবেলিং কাজের জন্য প্রতি ইউনিটে $0.02-0.10 খরচ হতে পারে; জটিল টীকা (চিকিৎসা, আইনি) প্রতি ইউনিটে $1-5 ছাড়িয়ে যেতে পারে; ট্রান্সক্রিপশন সহ স্পিচ ডেটার জন্য প্রায়শই প্রতি অডিও ঘন্টায় $5-30 খরচ হয়। সর্বদা QA, সংশোধন এবং ডেলিভারি খরচ সহ সর্ব-ইন মূল্যের অনুরোধ করুন।
"আমি কীভাবে জানব যে কোনও বিক্রেতার ডেটা আসলে 'পরিষ্কার' এবং আইনত উৎস থেকে প্রাপ্ত?"
উৎপত্তিস্থলের ডকুমেন্টেশন, লাইসেন্সিং শর্তাবলী এবং সম্মতি রেকর্ডের জন্য অনুরোধ করুন। বিশেষভাবে জিজ্ঞাসা করুন: "এই ডেটাসেটের জন্য, উৎস উপাদানটি কোথা থেকে এসেছে এবং মডেল প্রশিক্ষণের জন্য এটি ব্যবহার করার জন্য আমাদের কী অধিকার আছে?" স্বনামধন্য বিক্রেতারা এর সুনির্দিষ্ট উত্তর দিতে পারবেন।
"কৃত্রিম তথ্য কি যথেষ্ট, নাকি আমার আসল তথ্যের প্রয়োজন?"
সংশ্লেষিত তথ্য বৃদ্ধি, প্রান্তিক কেস এবং গোপনীয়তা-সংবেদনশীল পরিস্থিতির জন্য মূল্যবান। এটি সাধারণত প্রাথমিক প্রশিক্ষণ উৎস হিসাবে যথেষ্ট নয়—বিশেষ করে সাংস্কৃতিক সূক্ষ্মতা, ভাষাগত বৈচিত্র্য, অথবা বাস্তব-বিশ্বের প্রান্তিক কেস কভারেজের প্রয়োজন এমন কাজের জন্য। একটি মিশ্রণ ব্যবহার করুন এবং অনুপাতটি জানুন।
"১০,০০০-ইউনিট টীকা প্রকল্পের জন্য যুক্তিসঙ্গত টার্নঅ্যারাউন্ড সময় কত?"
ক্যালিব্রেশন সহ স্ট্যান্ডার্ড অ্যানোটেশন কাজের জন্য, 2-4 সপ্তাহ আশা করুন। জটিল ডোমেন বা বিশেষায়িত কাজগুলিতে 4-8 সপ্তাহ সময় লাগতে পারে। তাড়াহুড়ো করে ডেলিভারি করা প্রায়শই সম্ভব তবে সাধারণত খরচ 25-50% বৃদ্ধি করে।
"চুক্তি স্বাক্ষর করার আগে আমি কীভাবে মান মূল্যায়ন করব?"
একজন বেতনভুক্ত পাইলটের উপর জোর দিন। একজন বিক্রেতা যদি পাইলট এনগেজমেন্ট (এমনকি ছোট একটিও) করতে অনিচ্ছুক হন, তাহলে তা হুমকির মুখে। পাইলট চলাকালীন, আপনার নিজস্ব গুণমান পর্যালোচনা প্রয়োগ করুন—শুধুমাত্র বিক্রেতা-প্রতিবেদিত মেট্রিক্সের উপর নির্ভর করবেন না।
"কোন সম্মতি সার্টিফিকেশনগুলি সবচেয়ে গুরুত্বপূর্ণ?"
SOC 2 টাইপ II হল এন্টারপ্রাইজ ডেটা হ্যান্ডলিং এর বেসলাইন। স্বাস্থ্যসেবার জন্য, HIPAA BAA সম্পর্কে জিজ্ঞাসা করুন। EU কার্যক্রমের জন্য, নথিভুক্ত DPA প্রক্রিয়াগুলির সাথে GDPR সম্মতি নিশ্চিত করুন। ISO 27001 একটি ইতিবাচক সংকেত কিন্তু সর্বজনীনভাবে প্রয়োজনীয় নয়।
"আমি কি এন্টারপ্রাইজ এলএলএম প্রশিক্ষণের জন্য ক্রাউডসোর্সড ডেটা ব্যবহার করতে পারি?"
ক্রাউডসোর্সড ডেটা সাধারণ কাজের জন্য কাজ করতে পারে কিন্তু প্রায়শই এন্টারপ্রাইজ অ্যাপ্লিকেশনের জন্য প্রয়োজনীয় ধারাবাহিকতা এবং ডোমেন দক্ষতার অভাব থাকে। বিশেষায়িত ডোমেনের (আইনি, চিকিৎসা, আর্থিক) ক্ষেত্রে, নিবেদিতপ্রাণ বিশেষজ্ঞ টীকাকাররা সাধারণত ক্রাউডসোর্সড পদ্ধতির চেয়ে ভালো ফলাফল করেন।
"যদি আমার ডেটা প্রকল্পের মাঝামাঝি সময়ে পরিবর্তনের প্রয়োজন হয়?"
সুযোগ পরিবর্তনের পদ্ধতিগুলি আগে থেকেই আলোচনা করুন। পরিবর্তনগুলি মূল্য, সময়সীমা এবং মানের বেসলাইনগুলিকে কীভাবে প্রভাবিত করে তা বুঝুন। ML প্রকল্পগুলির সাথে অভিজ্ঞ বিক্রেতারা পুনরাবৃত্তি আশা করেন - কঠোর পরিবর্তনের আদেশ প্রক্রিয়াগুলি নমনীয়তা নির্দেশ করতে পারে।
"প্রশিক্ষণের তথ্যে আমি কীভাবে PII পরিচালনা করব?"
যেসব বিক্রেতারা ডি-আইডেন্টিফিকেশন প্রক্রিয়া প্রতিষ্ঠা করেছেন এবং তাদের পদ্ধতির ডকুমেন্টেশন প্রদান করতে পারেন তাদের সাথে কাজ করুন। সংবেদনশীল ডেটার জন্য, ডেটা ট্রান্সফার কমানোর জন্য অন-প্রিমিস বা ভিপিসি স্থাপনের বিকল্পগুলি নিয়ে আলোচনা করুন।
"তথ্য সংগ্রহ এবং তথ্য টীকাকরণের মধ্যে পার্থক্য কী?"
তথ্য সংগ্রহ হলো কাঁচা তথ্য সংগ্রহ বা তৈরি করা (বক্তৃতা রেকর্ড করা, টেক্সট নমুনা সংগ্রহ করা, ছবি তোলা)। তথ্য টীকা হলো বিদ্যমান তথ্য লেবেল করা (অডিও ট্রান্সক্রিপশন করা, অনুভূতি ট্যাগ করা, বাউন্ডিং বক্স আঁকা)। বেশিরভাগ প্রকল্পের জন্য উভয়েরই প্রয়োজন হয়, কখনও কখনও বিভিন্ন বিক্রেতাদের কাছ থেকে।
শাইপ কীভাবে আপনার এআই ডেটা দক্ষতা প্রদান করে
Shaip ডেটা সংগ্রহের জটিলতা দূর করে যাতে আপনি মডেল উদ্ভাবনের উপর মনোযোগ দিতে পারেন। আমাদের প্রমাণিত দক্ষতা এখানে:
গ্লোবাল স্কেল + গতি
- ৬০+ দেশের ৩০,০০০+ অবদানকারী, বিভিন্ন, বৃহৎ-আয়তনের ডেটাসেটের জন্য
- দ্রুত পরিবর্তনের মাধ্যমে ১৫০+ ভাষায় টেক্সট, অডিও, ছবি, ভিডিও সংগ্রহ করুন
- রিয়েল-টাইম টাস্ক বিতরণ এবং মান নিয়ন্ত্রণের জন্য মালিকানাধীন শাইপক্লাউড অ্যাপ
এন্ড-টু-এন্ড ওয়ার্কফ্লো
প্রয়োজনীয়তা → সংগ্রহ → পরিষ্কারকরণ → টীকা → QA → বিতরণ
শিল্প অনুসারে ডোমেন বিশেষজ্ঞরা
| শিল্প | শাইপ বিশেষজ্ঞ |
|---|---|
| স্বাস্থ্যসেবা | অ-শনাক্তকৃত ক্লিনিকাল ডেটা (৩১টি বিশেষত্ব), HIPAA-সম্মত, SME-পর্যালোচিত |
| কথোপকথন এআই | বহু-উচ্চারণমূলক বক্তৃতা, স্বাভাবিক উচ্চারণ, আবেগের ট্যাগিং |
| কম্পিউটার ভিশন | বস্তু সনাক্তকরণ, বিভাজন, প্রান্ত-কেস পরিস্থিতি |
| জেনএআই / এলএলএম | RLHF ডেটাসেট, যুক্তি শৃঙ্খল, নিরাপত্তা মানদণ্ড |
কেন দলগুলি শাইপকে বেছে নেয়
✅ পাইলট-প্রথম পদ্ধতি - স্কেলিংয়ের আগে ফলাফল প্রমাণ করুন
✅ ৭ দিনের মধ্যে নমুনা ডেটাসেট বিতরণ করা হবে - ঝুঁকিমুক্তভাবে আমাদের পরীক্ষা করুন
✅ ৯৫%+ আন্তঃ-টীকাকার চুক্তি - পরিমাপিত, প্রতিশ্রুতিবদ্ধ নয়
✅ বিশ্বব্যাপী বৈচিত্র্য – নকশা অনুসারে সুষম উপস্থাপনা
✅ অন্তর্নির্মিত সম্মতি - সংগ্রহ থেকে ডেলিভারি পর্যন্ত GDPR, HIPAA, CCPA
✅ স্কেলেবল মূল্য নির্ধারণ – পুনর্বিবেচনা ছাড়াই উৎপাদনের জন্য পাইলট
বাস্তব ফলাফল
- ভয়েস এআই: উচ্চারণ/উপভাষা জুড়ে ২৫% ভালো স্বীকৃতি
- স্বাস্থ্যসেবা NLP: ক্লিনিক্যাল মডেলগুলি শূন্য PHI এক্সপোজার সহ 3 গুণ দ্রুত প্রশিক্ষিত
- RAG সিস্টেম: কিউরেটেড গ্রাউন্ডিং ডেটার মাধ্যমে ৪০% পুনরুদ্ধারের উন্নতি
উপসংহার
সেরা এআই ট্রেনিং ডেটা সরবরাহকারী খুঁজে পাওয়ার কোনো সহজ উপায় জানতে চান ? আমাদের সাথে যোগাযোগ করুন। এই সমস্ত ক্লান্তিকর প্রক্রিয়া এড়িয়ে চলুন এবং আপনার এআই মডেলের জন্য সর্বোচ্চ মানের ও নির্ভুল ডেটাসেট পেতে আমাদের সাথে কাজ করুন।
আমরা এখন পর্যন্ত আলোচনা করা সমস্ত বাক্স চেক করি। এই স্থানটিতে অগ্রগামী হওয়ার কারণে, আমরা জানি যে একটি AI মডেল তৈরি করতে এবং স্কেল করতে কী লাগে এবং কীভাবে ডেটা সবকিছুর কেন্দ্রে থাকে।
আমরা এটাও বিশ্বাস করি যে ক্রেতার গাইড বিভিন্ন উপায়ে ব্যাপক এবং সম্পদপূর্ণ ছিল। এআই প্রশিক্ষণ যেমন জটিল তবে এই পরামর্শ এবং সুপারিশগুলির সাহায্যে আপনি এগুলিকে কম ক্লান্তিকর করতে পারেন। শেষ পর্যন্ত, আপনার পণ্যটি একমাত্র উপাদান যা শেষ পর্যন্ত এই সমস্ত থেকে উপকৃত হবে।
চল কথা বলি
প্রায়শই জিজ্ঞাসিত প্রশ্নাবলী (FAQ)
১. এআই ডেটা সংগ্রহ কী?
এআই ডেটা সংগ্রহ হল মেশিন লার্নিং মডেলগুলিকে প্রশিক্ষণ দেওয়ার জন্য ব্যবহৃত ডেটাসেটগুলি সোর্সিং, তৈরি এবং কিউরেট করার প্রক্রিয়া। এলএলএম এবং চ্যাটবটগুলির জন্য, এর মধ্যে কথোপকথন লগ, নির্দেশ-প্রতিক্রিয়া জোড়া, পছন্দের ডেটা এবং ডোমেন-নির্দিষ্ট টেক্সট কর্পোরা অন্তর্ভুক্ত রয়েছে।
২. ডেটার পরিমাণের চেয়ে ডেটার মান কেন বেশি গুরুত্বপূর্ণ?
আধুনিক এলএলএম তাদের প্রশিক্ষণ তথ্য থেকে প্যাটার্ন শেখে। ত্রুটি, পক্ষপাত বা অসঙ্গতি সহ নিম্নমানের ডেটা সরাসরি মডেলের কর্মক্ষমতা হ্রাস করে। একটি ছোট, উচ্চমানের ডেটাসেট প্রায়শই বৃহত্তর, কোলাহলপূর্ণ ডেটাসেটকে ছাড়িয়ে যায়।
৩. RLHF ডেটা কী?
RLHF (মানব প্রতিক্রিয়া থেকে শক্তিবৃদ্ধি শিক্ষা) ডেটাতে মানুষের পছন্দের টীকা থাকে যা মডেল আউটপুটগুলিকে পছন্দসই আচরণের সাথে সারিবদ্ধ করতে সাহায্য করে। টীকাকাররা মডেল প্রতিক্রিয়াগুলির তুলনা করে এবং নির্দেশ করে যে কোনটি ভাল, সারিবদ্ধকরণের জন্য প্রশিক্ষণ সংকেত তৈরি করে।
৪. কখন আমার সিন্থেটিক ডেটা ব্যবহার করা উচিত?
সিন্থেটিক ডেটা বাস্তব তথ্য বৃদ্ধি, উন্নততর তথ্য তৈরি এবং গোপনীয়তা-সংরক্ষণের বিকল্প তৈরির জন্য ভালো কাজ করে। এটিকে আপনার প্রাথমিক প্রশিক্ষণের উৎস হিসেবে ব্যবহার করা এড়িয়ে চলুন, বিশেষ করে সাংস্কৃতিক সূক্ষ্মতা বা বাস্তব-বিশ্বের বৈচিত্র্যের প্রয়োজন এমন কাজের জন্য।
৫. তথ্যের উৎপত্তি কী?
ডেটা উৎস হল একটি ডেটাসেটের নথিভুক্ত হেফাজতের শৃঙ্খল - এটি কোথা থেকে এসেছে, কীভাবে এটি সংগ্রহ করা হয়েছিল, কোন সম্মতি নেওয়া হয়েছিল এবং কোন লাইসেন্সগুলি এর ব্যবহার নিয়ন্ত্রণ করে। নিয়ন্ত্রক সম্মতির জন্য উৎস ক্রমবর্ধমানভাবে প্রয়োজন।
৬. একটি সাধারণ তথ্য সংগ্রহ প্রকল্পে কত সময় লাগে?
সময়সীমা সুযোগভেদে পরিবর্তিত হয়। একটি পাইলট (৫০০-২,০০০ ইউনিট) সাধারণত ২-৪ সপ্তাহ সময় নেয়। উৎপাদন প্রকল্প (১০,০০০-১০০,০০০+ ইউনিট) ১-৩ মাস সময় নিতে পারে। জটিল ডোমেন বা বহুভাষিক প্রকল্পগুলি অতিরিক্ত সময় যোগ করে।
৭. বিক্রেতাদের কোন সম্মতি সার্টিফিকেশন থাকা উচিত?
SOC 2 টাইপ II হল এন্টারপ্রাইজ ডেটা হ্যান্ডলিং এর মান। স্বাস্থ্যসেবা অ্যাপ্লিকেশনের জন্য HIPAA সম্মতি গুরুত্বপূর্ণ। EU-সম্পর্কিত ডেটার জন্য GDPR সম্মতি প্রয়োজন। ISO 27001 একটি ইতিবাচক অতিরিক্ত সংকেত।
৮. অনুমোদিত এবং স্ক্র্যাপড ডেটার মধ্যে পার্থক্য কী?
অনুমতিপ্রাপ্ত তথ্য স্পষ্ট সম্মতি বা যথাযথ লাইসেন্সের মাধ্যমে সংগ্রহ করা হয়। ওয়েবসাইট থেকে প্রায়শই অনুমোদন ছাড়াই বাতিলকৃত তথ্য সংগ্রহ করা হয়। আইনি এবং সুনামের ঝুঁকি কমাতে অনুমতিপ্রাপ্ত তথ্য ক্রমবর্ধমানভাবে প্রয়োজন।
৯. সম্পূর্ণভাবে কাজ শুরু করার আগে আমি কীভাবে ডেটার মান মূল্যায়ন করব?
স্পষ্ট গ্রহণযোগ্যতার মানদণ্ড সহ একটি অর্থপ্রদানকারী পাইলট প্রোগ্রাম চালান। শুধুমাত্র বিক্রেতার মেট্রিক্সের উপর নির্ভর না করে আপনার নিজস্ব গুণমান পর্যালোচনা প্রক্রিয়া প্রয়োগ করুন। বিশেষ করে অস্পষ্ট উদাহরণ এবং অস্পষ্ট উদাহরণ পরীক্ষা করুন।
১০. RAG মূল্যায়ন তথ্য কী?
RAG (Retrieval-Augmented Generation) মূল্যায়ন ডেটাতে কোয়েরি-ডকুমেন্ট-আনসার ট্রিপলেট থাকে যা পরীক্ষা করে যে কোনও সিস্টেম প্রাসঙ্গিক প্রসঙ্গ পুনরুদ্ধার করে এবং সঠিক প্রতিক্রিয়া তৈরি করে কিনা। RAG নির্ভুলতা পরিমাপ এবং উন্নত করার জন্য এটি অপরিহার্য।
১১. এআই ডেটা সংগ্রহের মূল্য কেমন?
মূল্য নির্ধারণের মডেলগুলির মধ্যে রয়েছে প্রতি ইউনিট (প্রতি টীকা, প্রতি চিত্র), প্রতি ঘন্টা (অডিও/ভিডিওর জন্য), এবং প্রকল্প-ভিত্তিক। QA, সংশোধন এবং ডেলিভারি সহ সর্বাত্মক মূল্য নির্ধারণের অনুরোধ করুন। জটিলতা এবং প্রয়োজনীয় ডোমেন দক্ষতার উপর নির্ভর করে খরচ ব্যাপকভাবে পরিবর্তিত হয়।
১২. এআই ডেটা সংগ্রহের জন্য একটি আরএফপিতে আমার কী অন্তর্ভুক্ত করা উচিত?
অন্তর্ভুক্ত: প্রকল্পের সুযোগ এবং ডেটার ধরণ, মানের প্রয়োজনীয়তা এবং গ্রহণযোগ্যতার মানদণ্ড, সম্মতির প্রয়োজনীয়তা, সময়সীমার সীমাবদ্ধতা, আয়তনের অনুমান, ফর্ম্যাট স্পেসিফিকেশন এবং বিক্রেতা নির্বাচনের জন্য মূল্যায়নের মানদণ্ড।
১৩. আমি কি আমার বিদ্যমান প্রশিক্ষণের তথ্য উন্নত করতে পারি?
হ্যাঁ। বিক্রেতারা ডেটা সমৃদ্ধকরণ, পুনঃটীকাকরণ এবং মান উন্নয়ন পরিষেবা প্রদান করে। আপনি এজ কেস যোগ করতে পারেন, জনসংখ্যার প্রতিনিধিত্বের ভারসাম্য বজায় রাখতে পারেন, অথবা বর্তমান পরিভাষা এবং তথ্য প্রতিফলিত করার জন্য ডেটা আপডেট করতে পারেন।