যখন পুরস্কারের সংকেত অনুকূল থাকে এবং পরিবেশ ক্ষমাশীল হয়, তখন কী করতে হবে তা শেখার ক্ষেত্রে রিইনফোর্সমেন্ট লার্নিং (RL) দারুণ কার্যকর। কিন্তু বাস্তব জগতের অনেক পরিস্থিতিই সেরকম হয় না। সেগুলো বিশৃঙ্খল, ঝুঁকিপূর্ণ এবং "প্রায় সঠিক" সিদ্ধান্তে পরিপূর্ণ থাকে। এখানেই বিশেষজ্ঞদের দ্বারা পরীক্ষিত রিজনিং ডেটাসেটগুলো একটি শক্তি গুণক হিসেবে কাজ করে: এগুলো মডেলকে কোনো কাজের পেছনের কারণ শেখায় —শুধু তার ফলাফল নয়।
আরএল পারফরম্যান্সে লুকানো বাধা: দুর্বল যুক্তি সংকেত
প্রশিক্ষণে RL এজেন্টরা চিত্তাকর্ষক দেখাতে পারে কিন্তু তবুও স্থাপনায় ব্যর্থ হতে পারে। একটি সাধারণ কারণ হল মডেলটি শর্টকাট শেখে - এমন প্যাটার্ন যা পরিচিত পরিস্থিতিতে পুরষ্কার অর্জন করে কিন্তু পরিস্থিতি পরিবর্তন হলে ভেঙে পড়ে।
আপনি যদি RL সিস্টেম পাঠিয়ে থাকেন তবে এখানে একটি ছোট গল্প আপনি চিনতে পারবেন:
একটি গুদাম রোবটিক্স দল একটি রোবটকে জিনিসপত্র তোলা ও রাখার জন্য প্রশিক্ষণ দেয়। সিমুলেশনে, সফলতার হার দ্রুত বাড়তে থাকে। কিন্তু আসল মেঝেতে, রোবটটি সেটআপের সাথে ‘গেম’ খেলতে শুরু করে—এমন ঝুঁকিপূর্ণ গতিপথ নেয় যা সিমুলেটরে কাজ করলেও প্রতিফলক পৃষ্ঠের কাছে সংঘর্ষ ঘটায়। রিওয়ার্ড ফাংশনটি ভুল ছিল না। মডেলটি যে যুক্তি শিখেছিল তা অসম্পূর্ণ ছিল।
যখন আপনার ডেটা কেবল ফলাফল ("সাফল্য/ব্যর্থতা" অথবা একটি স্কেলার পুরষ্কার) ধারণ করে, তখন আপনি মধ্যবর্তী সিদ্ধান্তের যুক্তিটি মিস করেন যা মানুষ সহজাতভাবে ব্যবহার করে: সীমাবদ্ধতা, নিরাপত্তা পরীক্ষা এবং ধাপ ক্রম।
"বিশেষজ্ঞ-পরীক্ষিত যুক্তিগত তথ্য" আসলে কী অন্তর্ভুক্ত করে
ব্যবহারিক স্তরে, বিশেষজ্ঞ-পরীক্ষিত যুক্তিগত তথ্য হল এমন কিছু উদাহরণের সেট যেখানে ডোমেন বিশেষজ্ঞরা সিদ্ধান্তের পথ যাচাই করেন - কেবল চূড়ান্ত ফলাফল নয়।
যুক্তির চিহ্ন: অনুপস্থিত মাঝখানে
একটি যুক্তির ট্রেস হল পর্যবেক্ষণ → সিদ্ধান্ত → কর্ম থেকে ধাপে ধাপে পথ। আপনার ব্যবহারের ক্ষেত্রের উপর নির্ভর করে, এটি দেখতে এরকম হতে পারে:
- প্রাসঙ্গিক সংকেত সনাক্তকরণ ("সেন্সর ড্রিফট সনাক্ত করা হয়েছে; আত্মবিশ্বাস হ্রাস পেয়েছে")
- ডোমেন নিয়ম প্রয়োগ করা ("প্রবেশের আগে ফলন দিন; পথচারীদের অগ্রাধিকার দিন")
- সীমাবদ্ধতা সহ ক্রিয়া নির্বাচন করা ("অন্ধ স্থান এড়াতে পথ B বেছে নিন")
"পরীক্ষিত" বলতে কী বোঝায় (সরল ইংরেজিতে)
"পরীক্ষিত" বলতে সাধারণত অন্তর্ভুক্ত থাকে:
- বিশেষজ্ঞ-লেখিত বা বিশেষজ্ঞ-পর্যালোচিত নির্দেশিকা
- সামঞ্জস্যপূর্ণ লেবেলিং রুব্রিক (যাতে দুজন বিশেষজ্ঞ একই কেস একইভাবে সমাধান করেন)
- দ্বন্দ্ব এবং অনুপস্থিত ধাপগুলির জন্য পদ্ধতিগত পরীক্ষা
- নির্দেশিকা বিকশিত হওয়ার সাথে সাথে পরিবর্তনের একটি অডিট ট্রেইল
এটি গুরুত্বপূর্ণ কারণ ছোট লজিক ত্রুটিগুলি ক্যাসকেড হতে পারে—বিশেষ করে যখন আপনি পরে পুরষ্কার মডেলগুলি প্রশিক্ষণ দেন বা মানব প্রতিক্রিয়া লুপ ব্যবহার করেন।
যুক্তি ডেটাসেটগুলি কীভাবে রিইনফোর্সমেন্ট লার্নিং মডেলের কর্মক্ষমতা উন্নত করে
সুবিধাগুলো রহস্যময় নয়। এগুলো যান্ত্রিক।
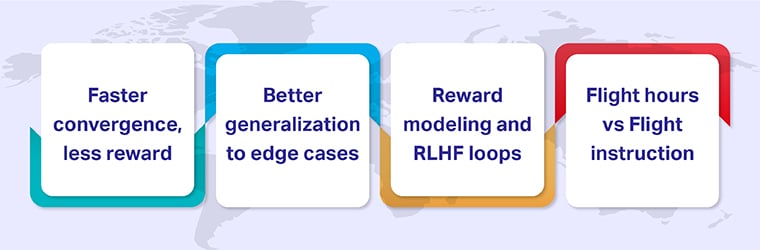
দ্রুত কনভারজেন্স, কম পুরষ্কার হ্যাকিং
যুক্তির ট্রেস অনুসন্ধানের স্থান কমিয়ে দেয়। অন্ধভাবে অনুসন্ধান করার পরিবর্তে, এজেন্ট কোন মধ্যবর্তী পদক্ষেপগুলি বৈধ তা সম্পর্কে কাঠামোগত সংকেত পায়। এর অর্থ সাধারণত প্রশিক্ষণের পুনরাবৃত্তি কম নষ্ট হয় এবং পুরষ্কার ফাংশনের "চতুর" ব্যবহার কম হয়।
RLHF এবং পুরষ্কার মডেলিং সম্পর্কিত গবেষণা বারবার তুলে ধরেছে যে প্রশিক্ষণ কতটা কোলাহলপূর্ণ বা নিম্নমানের পছন্দ/প্রতিক্রিয়া ডেটার প্রতি সংবেদনশীল হতে পারে (সূত্র: অ্যাসোসিয়েশন ফর কম্পিউটেশনাল লিঙ্গুইস্টিকস, ২০২৪)। RL-তে সেই সংবেদনশীলতা অদৃশ্য হয় না - এটি আরও বৃদ্ধি পায়।
প্রান্তিক ক্ষেত্রে আরও ভালো সাধারণীকরণ
বিশেষজ্ঞ যুক্তি এমন কিছু সীমাবদ্ধতা ও নীতিকে ধারণ করে যা স্থানান্তরিত হয়: যেমন সুরক্ষার সীমা, সম্মতির নিয়ম এবং কার্যকারণ যুক্তি। যখন পরিবেশ পরিবর্তিত হয়, তখনও সেই নীতিগুলো কার্যকর থাকে—এমনকি যদি নির্দিষ্ট পিক্সেল, টেক্সট বা অবস্থার পরিবর্তন না-ও ঘটে।
আরও স্থিতিশীল পুরষ্কার মডেলিং এবং RLHF লুপ
যদি আপনি RLHF-স্টাইলের পোস্ট-ট্রেনিং ব্যবহার করেন, তাহলে যুক্তিগত তথ্য আপনাকে আরও ভালো পুরষ্কার মডেল তৈরি করতে সাহায্য করবে—কারণ পুরষ্কার মডেলটি কেবল "ভালো উত্তর" নয়, "ভালো সিদ্ধান্তের পথ" স্কোর করতে শিখতে পারে। এটি অপ্টিমাইজেশনের সময় আরও সামঞ্জস্যপূর্ণ আপডেট এবং প্রশিক্ষণ স্কেল করার সময় কম রিগ্রেশনে অনুবাদ করে।
আপনি যদি RLHF পাইপলাইন তৈরি বা সম্প্রসারণ করেন, তবে Shaip-এর RLHF সলিউশনগুলো বিশেষজ্ঞ-পরিচালিত ওয়ার্কফ্লো এবং কোয়ালিটি কন্ট্রোলকে কেন্দ্র করে ডিজাইন করা হয়েছে, যা সামঞ্জস্যপূর্ণ অ্যালাইনমেন্ট ডেটা প্রদানে সহায়তা করে।
একটি উপমা: ফ্লাইটের সময় বনাম ফ্লাইটের নির্দেশনা
আরএল প্রশিক্ষণকে পাইলট প্রশিক্ষণের মতো করে ভাবুন। আপনি একা একটি সিমুলেটরেই ঘণ্টার পর ঘণ্টা অনুশীলন করতে পারেন—কিন্তু যদি আপনি ভুল অভ্যাসগুলো চর্চা করেন, তবে সেগুলো আরও পাকাপোক্ত হবে। একজন প্রশিক্ষক শুধু “পাস/ফেল” বলে দেন না। তাঁরা উড্ডয়নের মাঝপথেই আপনার যুক্তিবোধ সংশোধন করেন: যেমন স্ক্যান করার ক্রম, সিদ্ধান্ত নেওয়ার সময় এবং ঝুঁকি সামলানোর পদ্ধতি। বিশেষজ্ঞদের দ্বারা পরীক্ষিত রিজনিং ডেটাসেটগুলো আরএল-এর জন্য সেই “প্রশিক্ষকের” ভূমিকা পালন করে—মডেলকে শেখায় কীভাবে কাজটি নিয়ে গভীরভাবে চিন্তা করতে হয়, শুধু এটি অবতরণ করতে পেরেছে কি না তা নয়।
তুলনা সারণী: ইন-হাউস বনাম ক্রাউডসোর্সড বনাম আউটসোর্সড ভেটিং মডেল
বেশিরভাগ দলই একটি হাইব্রিড নিয়ে শেষ হয়, তবে লেনদেনের বিষয়ে স্পষ্টভাবে বলা সাহায্য করে।
আরএল (RL) এবং আরএলএইচএফ (RLHF) পাইপলাইনের সাথে সংযুক্ত বৃহত্তর লেবেলিং চাহিদার জন্য, শাইপ-এর ডেটা অ্যানোটেশন পরিষেবা নির্দেশিকা ডিজাইন থেকে শুরু করে বহু-পর্যায়ের কিউএ (QA) পর্যন্ত সবকিছুতে সহায়তা করতে পারে—বিশেষ করে যখন আপনার বৃহৎ পরিসরে পুনরাবৃত্তিযোগ্য গুণমান প্রয়োজন হয়।
বিশেষজ্ঞ-পরীক্ষিত যুক্তি ডেটাসেটের জন্য একটি ব্যবহারিক QC প্লেবুক
এখানে একটি প্লেবুক দেওয়া হল যা উচ্চ-কার্যক্ষম দলগুলি কী কী কার্য সম্পাদন করে তার মানচিত্র তৈরি করে।
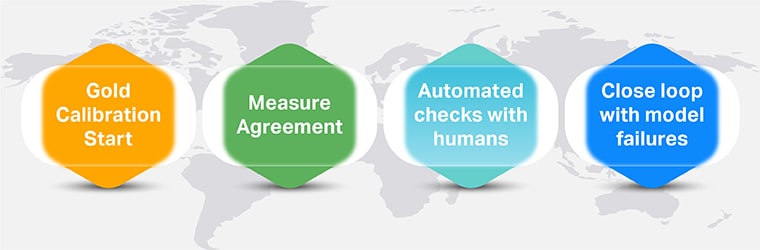
১. "সোনা" এবং ক্রমাঙ্কন দিয়ে শুরু করুন
ক্যানোনিকাল উদাহরণের একটি সোনালী সেট তৈরি করুন (ট্রিকি এজ কেস সহ)। টীকাকারদের ক্যালিব্রেট করতে এবং "ভালো যুক্তি" কেমন দেখায় তা বিশেষজ্ঞদের সাথে সারিবদ্ধ করতে এটি ব্যবহার করুন।
২. একমত হওয়া পরিমাপ করো—তারপর মতবিরোধ সঠিকভাবে সমাধান করো
যেখানে যুক্তিযুক্ত, সেখানে টীকাকারদের নিজেদের মধ্যেকার মতৈক্য ব্যবহার করুন (এবং স্বভাবগতভাবে অস্পষ্ট ক্ষেত্রে জোর করে মতৈক্য চাপিয়ে দেওয়া থেকে বিরত থাকুন)। মূল বিষয় হলো মধ্যস্থতা : মতবিরোধের ফলে আরও ভালো নির্দেশিকা তৈরি হওয়া উচিত, কেবল ভাগ্য পরীক্ষার মতো কোনো লেবেল নয়।
৩. স্বয়ংক্রিয় চেক যোগ করুন, কিন্তু মানুষের হাতে দায়িত্ব রাখুন
যা যাচাই করা সস্তা তা স্বয়ংক্রিয় করুন:
- বিন্যাসের ধারাবাহিকতা (ধাপের সংখ্যা, স্কিমার বৈধতা)
- নিয়ম লঙ্ঘন (সীমাবদ্ধতা অনুপস্থিত, নিষিদ্ধ কর্ম)
- দ্বন্দ্ব সনাক্তকরণ (ধাপটি "A" বলে, পরে "A নয়" বোঝায়)
তারপর চিহ্নিত জিনিসগুলিকে বিশেষজ্ঞ পর্যালোচনার জন্য পাঠান। এখানেই হাইব্রিড হিউম্যান+এআই কিউসি লাভজনক: মেশিনগুলি "স্পষ্ট ভুল" ধরে, বিশেষজ্ঞরা "সূক্ষ্ম ভুল" ঠিক করে।
৪. মডেল ব্যর্থতার সাথে লুপটি বন্ধ করুন
স্থাপনার ব্যর্থতাগুলিকে ডেটাসেটের প্রতিক্রিয়া হিসাবে বিবেচনা করুন। যখন মডেলটি ব্যর্থ হয়, তখন জিজ্ঞাসা করুন:
- যুক্তির ট্রেসে কি কোনও সীমাবদ্ধতা অনুপস্থিত ছিল?
- নির্দেশিকা কি প্রান্তের কেসটিকে কম উল্লেখ করেছে?
- আমরা কি "সুখী পথ" যুক্তির উপর অতিরিক্ত নির্ভরশীল?
এই চক্রটি আপনার ডেটাসেটকে একটি জীবন্ত সম্পদে পরিণত করে, কোনো এককালীন সরবরাহযোগ্য বস্তুতে নয়। যে দলগুলো শুরু থেকে শেষ পর্যন্ত (সংগ্রহ → গুণমান নিশ্চিতকরণ → সরবরাহ) ডেটা পাইপলাইন তৈরি করে, তাদের জন্য শাইপ-এর এআই প্রশিক্ষণ ডেটা পরিষেবা এই প্রক্রিয়াটিকে নিরবচ্ছিন্নভাবে কার্যকর করতে সাহায্য করতে পারে।
সিদ্ধান্ত কাঠামো: সঠিক যাচাই কৌশল কীভাবে বেছে নেবেন
অভ্যন্তরীণ, জনবহুল এবং পরিচালিত পরিষেবার সঠিক মিশ্রণটি বেছে নিতে এই ছয়টি প্রশ্ন ব্যবহার করুন: