শুধুমাত্র স্বয়ংক্রিয় স্কোরের দিকে তাকালে বেশিরভাগ এলএলএম-কেই চমৎকার মনে হয়—যতক্ষণ না তারা সূক্ষ্মভাবে ভুল, ঝুঁকিপূর্ণ বা বেমানান কিছু লেখে। স্থির বেঞ্চমার্ক যা পরিমাপ করে এবং আপনার ব্যবহারকারীদের আসলে যা প্রয়োজন, তার মধ্যে এটাই হলো ব্যবধান। এই নির্দেশিকায়, আমরা দেখাবো কীভাবে অটোমেশনের সাথে মানবিক বিচার-বিবেচনা (HITL) মেলানো যায়, যাতে আপনার এলএলএম বেঞ্চমার্কিং শুধুমাত্র টোকেন-স্তরের নির্ভুলতা নয়, বরং সত্যতা, নিরাপত্তা এবং ডোমেইনের সাথে উপযুক্ততাকে প্রতিফলিত করে।
এলএলএম বেঞ্চমার্কিং আসলে কী পরিমাপ করে
স্বয়ংক্রিয় মেট্রিক্স এবং লিডারবোর্ডগুলি দ্রুত এবং পুনরাবৃত্তিযোগ্য। বহু-পছন্দের কাজে নির্ভুলতা, পাঠ্যের সাদৃশ্যের জন্য BLEU/ROUGE এবং ভাষা মডেলিংয়ের জন্য জটিলতা দিকনির্দেশনামূলক সংকেত দেয়। কিন্তু তারা প্রায়শই যুক্তির শৃঙ্খল, বাস্তব ভিত্তি এবং নীতি সম্মতি মিস করে—বিশেষ করে উচ্চ-স্তরের প্রেক্ষাপটে। এই কারণেই আধুনিক প্রোগ্রামগুলি বহু-মেট্রিক, স্বচ্ছ প্রতিবেদন এবং দৃশ্যকল্প বাস্তবতার উপর জোর দেয়।
স্বয়ংক্রিয় মেট্রিক্স এবং স্ট্যাটিক পরীক্ষার সেট
চিরায়ত পরিমাপ পদ্ধতিকে একটি স্পিডোমিটারের মতো ভাবুন —মসৃণ হাইওয়েতে আপনি কত দ্রুত যাচ্ছেন, তা জানানোর জন্য এটি চমৎকার। কিন্তু বৃষ্টিতে ব্রেক কাজ করবে কি না, তা এটি বলে না। BLEU/ROUGE/perplexity তুলনীয়তায় সাহায্য করে, কিন্তু মুখস্থ করে বা বাহ্যিক মিলের মাধ্যমে এগুলোকে ফাঁকি দেওয়া যায়।
যেখানে তারা কম পড়ে
প্রকৃত ব্যবহারকারীরা অস্পষ্টতা, ডোমেনের পরিভাষা, পরস্পরবিরোধী লক্ষ্য এবং পরিবর্তনশীল নিয়মকানুন নিয়ে আসে। স্ট্যাটিক টেস্ট সেটগুলি খুব কমই এটি ধারণ করে। ফলস্বরূপ, সম্পূর্ণ স্বয়ংক্রিয় মানদণ্ডগুলি জটিল এন্টারপ্রাইজ কাজের জন্য মডেল প্রস্তুতিকে অতিরঞ্জিত করে। HELM/AIR-Bench-এর মতো সম্প্রদায়ের প্রচেষ্টা আরও মাত্রা (দৃঢ়তা, নিরাপত্তা, প্রকাশ) কভার করে এবং স্বচ্ছ, বিকশিত স্যুট প্রকাশ করে এই সমস্যা সমাধান করে।
এলএলএম বেঞ্চমার্কে মানব মূল্যায়নের ক্ষেত্রে
কিছু গুণাবলী মানুষের সহজাত বৈশিষ্ট্য হয়েই থাকে: বাচনভঙ্গি, সহযোগিতাপূর্ণ মনোভাব, সূক্ষ্ম শুদ্ধতা, সাংস্কৃতিক উপযোগিতা এবং ঝুঁকি নেওয়ার প্রবণতা। যথাযথভাবে প্রশিক্ষিত ও পরিমার্জিত মানব মূল্যায়নকারীরাই এই গুণগুলোর জন্য আমাদের কাছে থাকা সেরা মাধ্যম। কৌশলটি হলো এদেরকে বেছে বেছে এবং পদ্ধতিগতভাবে ব্যবহার করা , যাতে খরচ সহনীয় থাকে এবং গুণমানও উচ্চ থাকে।
কখন মানুষকে সম্পৃক্ত করতে হবে
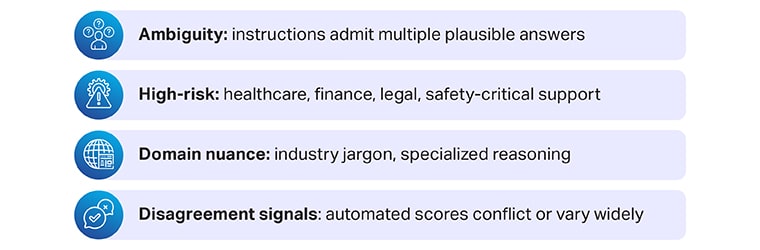
- অস্পষ্টতা: নির্দেশাবলী একাধিক সম্ভাব্য উত্তর গ্রহণ করে।
- উচ্চ ঝুঁকি: স্বাস্থ্যসেবা, অর্থ, আইনি, নিরাপত্তা-সমালোচনামূলক সহায়তা।
- ডোমেনের সূক্ষ্মতা: শিল্প পরিভাষা, বিশেষায়িত যুক্তি।
- মতবিরোধের সংকেত: স্বয়ংক্রিয় স্কোরগুলির মধ্যে বিরোধ বা ব্যাপকভাবে তারতম্য দেখা যায়।
রুব্রিক ডিজাইন এবং ক্যালিব্রেশন (সহজ উদাহরণ)
সঠিকতা , যৌক্তিকতা এবং নীতির সাথে সামঞ্জস্যের জন্য ১-৫ স্কেল দিয়ে শুরু করুন । প্রতিটি স্কোরের জন্য ২-৩টি টীকাসহ উদাহরণ দিন। সংক্ষিপ্ত ক্রমাঙ্কন পর্ব পরিচালনা করুন : মূল্যায়নকারীরা একটি সম্মিলিত ব্যাচকে স্কোর দেবেন, তারপর সামঞ্জস্য আরও জোরদার করার জন্য যুক্তিগুলো তুলনা করবেন। মূল্যায়নকারীদের মধ্যকার মতৈক্য পর্যবেক্ষণ করুন এবং প্রান্তিক ক্ষেত্রগুলোর জন্য নিষ্পত্তির ব্যবস্থা করুন।
পদ্ধতি: এলএলএম-এজ-এ-জজ থেকে ট্রু এইচআইটিএল পর্যন্ত
বিচারক হিসেবে এলএলএম (একটি মডেল ব্যবহার করে অন্য একটি মডেলের মূল্যায়ন করা) অগ্রাধিকার নির্ধারণের জন্য উপযোগী : এটি দ্রুত, সস্তা এবং সরল যাচাইয়ের জন্য ভালোভাবে কাজ করে। কিন্তু এরও একই ধরনের সীমাবদ্ধতা থাকতে পারে—যেমন ভ্রান্ত ধারণা, ভ্রান্ত সম্পর্ক বা “গ্রেড স্ফীতি”। মানুষের পর্যালোচনার জন্য কেসগুলোকে অগ্রাধিকার দিতে এটি ব্যবহার করুন , তার বিকল্প হিসেবে নয়।
একটি ব্যবহারিক হাইব্রিড পাইপলাইন
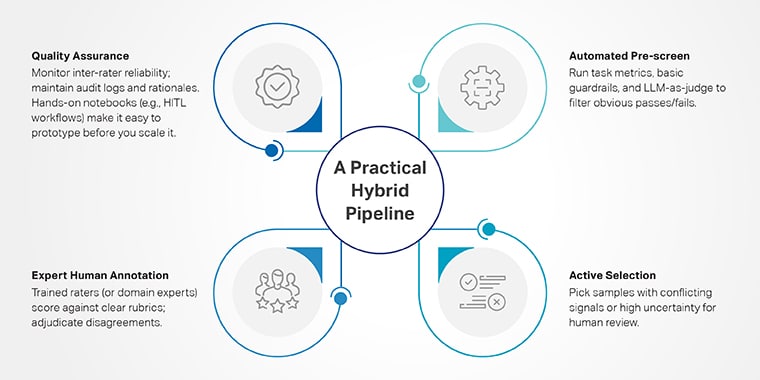
- স্বয়ংক্রিয় প্রি-স্ক্রিন: স্পষ্ট পাস/ব্যর্থতা ফিল্টার করার জন্য টাস্ক মেট্রিক্স, বেসিক গার্ডেল এবং LLM-as-judge চালান।
- সক্রিয় নির্বাচন: মানব পর্যালোচনার জন্য পরস্পরবিরোধী সংকেত বা উচ্চ অনিশ্চয়তা সহ নমুনাগুলি বেছে নিন।
- বিশেষজ্ঞ মানব টীকা: প্রশিক্ষিত রেটিংকারীরা (অথবা ডোমেন বিশেষজ্ঞরা) স্পষ্ট রুব্রিকের ভিত্তিতে স্কোর করেন; মতবিরোধের বিচার করেন।
- গুণ নিশ্চিত করা: ইন্টার-রেটার নির্ভরযোগ্যতা পর্যবেক্ষণ করুন; অডিট লগ এবং যুক্তি বজায় রাখুন। হ্যান্ড-অন নোটবুক (যেমন, HITL ওয়ার্কফ্লো) এই লুপটিকে স্কেল করার আগে প্রোটোটাইপ করা সহজ করে তোলে।
তুলনা সারণী: অটোমেটেড বনাম এলএলএম-এজ-জজ বনাম এইচআইটিএল
নিরাপত্তা এবং ঝুঁকির মানদণ্ড ভিন্ন
নিয়ন্ত্রক সংস্থা এবং মান নির্ধারক সংস্থাগুলো এমন মূল্যায়ন প্রত্যাশা করে, যা ঝুঁকি নথিভুক্ত করে, বাস্তবসম্মত পরিস্থিতি পরীক্ষা করে এবং তদারকি প্রদর্শন করে। NIST AI RMF (2024 GenAI প্রোফাইল) একটি সাধারণ পরিভাষা ও অনুশীলন পদ্ধতি প্রদান করে; NIST GenAI মূল্যায়ন কর্মসূচি ক্ষেত্র-নির্দিষ্ট পরীক্ষা চালু করছে; এবং HELM/AIR-Bench বহুমাত্রিক ও স্বচ্ছ ফলাফলের ওপর আলোকপাত করে। আপনার শাসনব্যবস্থার বিবরণকে দৃঢ় করতে এগুলো ব্যবহার করুন।
নিরাপত্তা নিরীক্ষার জন্য কী সংগ্রহ করতে হবে
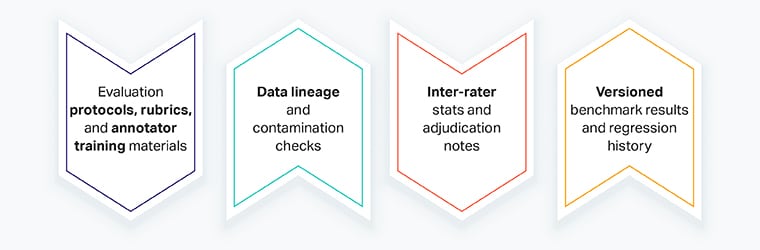
- মূল্যায়ন প্রোটোকল, রুব্রিক্স, এবং টীকাকার প্রশিক্ষণ উপকরণ
- তথ্য বংশ এবং দূষণ পরীক্ষা
- ইন্টার-রেটর পরিসংখ্যান এবং রায় নোট
- সংস্করণ করা হয়েছে বেঞ্চমার্ক ফলাফল এবং রিগ্রেশন ইতিহাস
ছোট গল্প: ব্যাংকিং কেওয়াইসি-তে ভুল ইতিবাচকতা দূর করা
একটি ব্যাংকের KYC বিশ্লেষক দল কমপ্লায়েন্স অ্যালার্টের সারসংক্ষেপ করার জন্য দুটি মডেল পরীক্ষা করেছিল। স্বয়ংক্রিয় স্কোরগুলো একই ছিল। HITL পর্যালোচনার সময়, মূল্যায়নকারীরা লক্ষ্য করেন যে মডেল A প্রায়শই নেতিবাচক নির্দেশক (“পূর্বে কোনো নিষেধাজ্ঞা নেই”) বাদ দিয়ে অর্থ পাল্টে দিচ্ছিল। পর্যালোচনার পর, ব্যাংকটি মডেল B বেছে নেয় এবং নির্দেশিকাগুলো হালনাগাদ করে। এক সপ্তাহের মধ্যে ভুল শনাক্তকরণের হার ১৮% কমে যায়, ফলে বিশ্লেষকরা প্রকৃত তদন্তের জন্য সময় পান। (শিক্ষা: স্বয়ংক্রিয় স্কোর একটি সূক্ষ্ম, কিন্তু গুরুতর ত্রুটি ধরতে পারেনি; HITL সেটি ধরে ফেলে।)
যেখানে শাইপ সাহায্য করে
- শব্দকোষ এবং শিক্ষা: হিউম্যান-ইন-দ্য-লুপ এবং কেন এটি GenAI-এর জন্য গুরুত্বপূর্ণ, তার সরল-ইংরেজি ব্যাখ্যা।
- কীভাবে করবেন এবং কৌশল: A এলএলএম মূল্যায়নের জন্য শিক্ষানবিসদের নির্দেশিকা শুরু থেকে শুরু করে দলগুলোর জন্য।
- প্ল্যাটফর্ম: A জেনারেটিভ এআই মূল্যায়ন এবং পর্যবেক্ষণ প্ল্যাটফর্ম ট্রায়েজ, পরীক্ষা-নিরীক্ষা এবং নিরীক্ষা কার্যকর করা।