তোমার হয়তো এই অভিজ্ঞতা হয়েছে: একজন ভয়েস অ্যাসিস্ট্যান্ট তোমার বন্ধুর কথা পুরোপুরি বোঝে, কিন্তু তোমার উচ্চারণ বা তোমার বাবা-মায়ের কথা বলার ধরণ নিয়ে তার সমস্যা হয়।
একই ভাষা। একই অনুরোধ। খুব আলাদা ফলাফল।
ঠিক এই শূন্যস্থানটিতেই সমাজধ্বনিবিজ্ঞানের অবস্থান — এবং একারণেই এটি কৃত্রিম বুদ্ধিমত্তার জন্য হঠাৎ এতটা গুরুত্বপূর্ণ হয়ে উঠেছে।
সোশিওফোনেটিক্স আলোচনা করে কীভাবে সামাজিক উপাদান এবং বাকধ্বনি একে অপরের সাথে মিথস্ক্রিয়া করে । যখন এটিকে স্পিচ টেকনোলজির সাথে যুক্ত করা হয়, তখন এটি আরও ন্যায্য ও নির্ভরযোগ্য এএসআর, টিটিএস এবং ভয়েস অ্যাসিস্ট্যান্ট তৈরির জন্য একটি শক্তিশালী মাধ্যম হয়ে ওঠে ।
এই প্রবন্ধে, আমরা সোসিওফোনেটিক্সকে সহজ ভাষায় ব্যাখ্যা করব, তারপর দেখাব কীভাবে এটি আপনার বক্তৃতা ডেটা ডিজাইন করার, মডেলগুলি প্রশিক্ষণ দেওয়ার এবং কর্মক্ষমতা মূল্যায়ন করার পদ্ধতিকে রূপান্তরিত করতে পারে।
১. ভাষাতত্ত্ব থেকে কৃত্রিম বুদ্ধিমত্তা: কেন সমাজ-ধ্বনিবিদ্যা হঠাৎ প্রাসঙ্গিক হয়ে উঠল
কয়েক দশক ধরে, সমাজবিজ্ঞান মূলত একটি একাডেমিক বিষয় ছিল। গবেষকরা এটি ব্যবহার করে নিম্নলিখিত প্রশ্নগুলি অধ্যয়ন করেছেন:
- বিভিন্ন সামাজিক গোষ্ঠী কীভাবে "একই" ধ্বনি উচ্চারণ করে?
- উচ্চারণের ক্ষুদ্র পার্থক্য থেকে শ্রোতারা কীভাবে সামাজিক ইঙ্গিতগুলি - বয়স, অঞ্চল, পরিচয় - বুঝতে পারে?
এখন, AI পণ্য সভাগুলিতে এই প্রশ্নগুলি নিয়ে এসেছে।
আধুনিক স্পিচ সিস্টেমগুলো বিভিন্ন দেশ, উপভাষা এবং সামাজিক প্রেক্ষাপট জুড়ে লক্ষ লক্ষ ব্যবহারকারীর কাছে ব্যবহৃত হয় । যখনই কোনো মডেল একটি নির্দিষ্ট উচ্চারণভঙ্গি, বয়স-গোষ্ঠী বা সম্প্রদায়ের ক্ষেত্রে সমস্যায় পড়ে, তখন তা কেবল একটি বাগ নয় — এটি হলো মানুষ যেভাবে কথা বলে এবং মডেলটি তাদের কাছ থেকে যেমনটা আশা করে, তার মধ্যেকার একটি সামাজিক-ধ্বনিতাত্ত্বিক অমিল ।
এই কারণেই দলগুলি কাজ করছে ASR, TTS, এবং ভয়েস UX জিজ্ঞাসা করতে শুরু করছে:
"আমরা কীভাবে নিশ্চিত করব যে আমাদের প্রশিক্ষণ এবং মূল্যায়ন সত্যিই আমরা কাকে সেবা দিতে চাই তা প্রতিফলিত করে?"
২. সমাজ-ধ্বনিবিদ্যা কী? (সরল-ভাষার সংজ্ঞা)
আনুষ্ঠানিকভাবে, সমাজধ্বনিবিজ্ঞান হলো ভাষাবিজ্ঞানের সেই শাখা যা সমাজভাষাবিজ্ঞান (বিভিন্ন সামাজিক গোষ্ঠীর মধ্যে ভাষার ভিন্নতা) এবং ধ্বনিবিজ্ঞান (বাকধ্বনির অধ্যয়ন)-কে সমন্বিত করে।
বাস্তবে, এটি এই ধরনের প্রশ্ন জিজ্ঞাসা করে:
- বয়স, লিঙ্গ, অঞ্চল, জাতিগততা এবং সামাজিক শ্রেণী উচ্চারণকে কীভাবে প্রভাবিত করে?
- শ্রোতারা কীভাবে সূক্ষ্ম শব্দের পার্থক্য ব্যবহার করে কেউ কোথা থেকে এসেছে তা চিনতে পারে, অথবা তারা নিজেকে কীভাবে দেখে?
- সম্প্রদায় এবং পরিচয়ের পরিবর্তনের সাথে সাথে সময়ের সাথে সাথে এই ধরণগুলি কীভাবে পরিবর্তিত হয়?
আপনি এটিকে এভাবে ভাবতে পারেন: যদি ধ্বনিবিদ্যা হল ক্যামেরা যা বক্তৃতার শব্দ ধারণ করে, তাহলে সমাজবিজ্ঞান হল সেই তথ্যচিত্র যা দেখায় যে কীভাবে প্রকৃত মানুষ পরিচয়, স্বত্ব এবং আবেগের সংকেত দেওয়ার জন্য এই শব্দগুলি ব্যবহার করে।
কয়েকটি সুনির্দিষ্ট উদাহরণ:
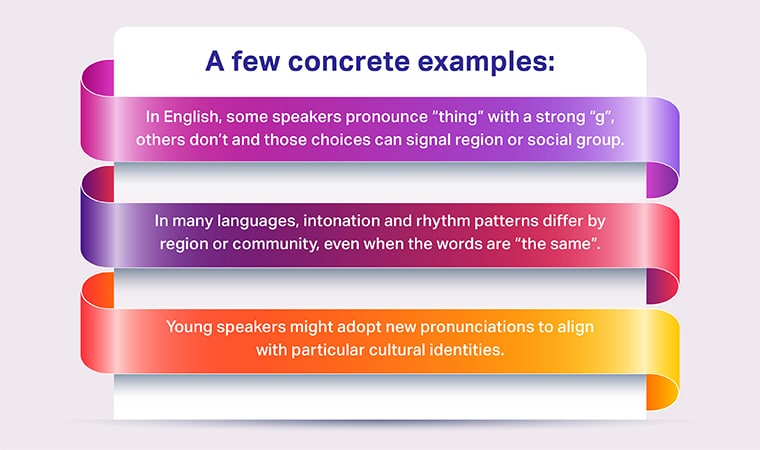
- ইংরেজিতে, কিছু বক্তা "thing" কে "g" দিয়ে উচ্চারণ করেন, অন্যরা করেন না — এবং এই পছন্দগুলি অঞ্চল বা সামাজিক গোষ্ঠীর ইঙ্গিত দিতে পারে।
- অনেক ভাষায়, শব্দগুলি "একই" হলেও, অঞ্চল বা সম্প্রদায় অনুসারে স্বর এবং ছন্দের ধরণ ভিন্ন হয়।
- তরুণ বক্তারা নির্দিষ্ট সাংস্কৃতিক পরিচয়ের সাথে সামঞ্জস্যপূর্ণ করার জন্য নতুন উচ্চারণ গ্রহণ করতে পারে।
ধ্বনিতে কীভাবে সামাজিক অর্থ সংকেতায়িত হয়, তা বোঝার জন্য সমাজধ্বনিবিজ্ঞান এই বিন্যাসগুলো বিশদভাবে অধ্যয়ন করে—প্রায়শই ধ্বনিগত পরিমাপ, উপলব্ধি পরীক্ষা এবং বৃহৎ ডেটাসেটের সাহায্যে ।
একটি সহজবোধ্য পরিচিতির জন্য, sociophonetics.com-এ দেওয়া ব্যাখ্যাটি দেখুন।
৩. সমাজবিজ্ঞান কীভাবে বক্তৃতার বৈচিত্র্য অধ্যয়ন করে
সমাজ-ধ্বনিগত গবেষণা সাধারণত দুটি বিস্তৃত ক্ষেত্রের দিকে নজর দেয়:
- উত্পাদনের - মানুষ আসলে কীভাবে শব্দ উৎপন্ন করে।
- উপলব্ধি – শ্রোতারা কীভাবে সেই শব্দগুলি এবং সেগুলি বহনকারী সামাজিক সংকেতগুলিকে ব্যাখ্যা করে।
কিছু মূল উপাদান:
- বিভাগীয় বৈশিষ্ট্য: স্বরবর্ণ এবং ব্যঞ্জনবর্ণ (উদাহরণস্বরূপ, /r/ অথবা নির্দিষ্ট স্বরবর্ণ অঞ্চলভেদে কীভাবে পৃথক হয়)।
- সুপারসেগমেন্টাল (প্রোসোডি): ছন্দ, চাপ এবং স্বরধ্বনির ধরণ।
- ভয়েস গুণমান: শ্বাসকষ্ট, কড়কড় শব্দ, এবং অন্যান্য গুণাবলী যা সামাজিক অর্থ বহন করতে পারে।
পদ্ধতিগতভাবে, সমাজ-ধ্বনিগত কাজে ব্যবহার করা হয়:
- শাব্দ বিশ্লেষণ (ফর্ম্যান্ট, পিচ, সময় পরিমাপ)।
- উপলব্ধি পরীক্ষা (শ্রোতারা কীভাবে বক্তৃতার নমুনাগুলিকে শ্রেণীবদ্ধ করেন বা বিচার করেন)।
- সমাজভাষাগত সাক্ষাৎকার এবং কর্পোরা (বাস্তব কথোপকথনের বৃহৎ ডেটাসেট, সামাজিক কারণগুলির জন্য টীকাযুক্ত)।
মূল কথা হলো, বৈচিত্র্য কোনো “গোলমাল” নয় — এটি সুসংগঠিত, অর্থবহ এবং সামাজিকভাবে বিন্যস্ত ।
ঠিক এই কারণেই AI এটিকে উপেক্ষা করতে পারে না।
৪. যেখানে সমাজবিজ্ঞান কৃত্রিম বুদ্ধিমত্তা এবং বক্তৃতা প্রযুক্তির সাথে মিলিত হয়
স্পিচ টেকনোলজি — যেমন এএসআর, টিটিএস, ভয়েস বট — স্পিচ ডেটার ওপর ভিত্তি করে তৈরি । যদি সেই ডেটা সামাজিক-ধ্বনিতাত্ত্বিক বৈচিত্র্যকে ধারণ করতে না পারে, তবে নির্দিষ্ট কিছু গোষ্ঠীর ক্ষেত্রে মডেলগুলো অনিবার্যভাবে প্রায়শই ব্যর্থ হবে।
উচ্চারিত ASR এর উপর গবেষণা দেখায় যে:
- কিছু উচ্চারণ এবং উপভাষার ক্ষেত্রে শব্দ ত্রুটির হার নাটকীয়ভাবে বেশি হতে পারে।
- সীমিত প্রশিক্ষণ তথ্য সহ উচ্চারিত বক্তৃতা বিশেষভাবে চ্যালেঞ্জিং।
- বিভিন্ন উপভাষায় সাধারণীকরণের জন্য সমৃদ্ধ, বৈচিত্র্যপূর্ণ ডেটাসেট এবং সতর্ক মূল্যায়ন প্রয়োজন।
একটি সামাজিক-ধ্বনিগত দৃষ্টিকোণ থেকে, সাধারণ ব্যর্থতার ধরণগুলির মধ্যে রয়েছে:
- উচ্চারণ পক্ষপাত: "স্ট্যান্ডার্ড" বা সুপ্রতিষ্ঠিত উচ্চারণের জন্য সিস্টেমটি সবচেয়ে ভালো কাজ করে।
- স্থানীয় রূপের অ-স্বীকৃতি: আঞ্চলিক উচ্চারণ, স্বরবর্ণের পরিবর্তন এবং ছন্দের ধরণ ভুলভাবে শনাক্ত করা হয়।
- অসম ইউএক্স: কিছু ব্যবহারকারী মনে করেন যে সিস্টেমটি "আমার মতো লোকেদের জন্য তৈরি করা হয়নি।"
সমাজধ্বনিবিজ্ঞান আপনাকে এই সমস্যাগুলো চিহ্নিত করতে ও পরিমাপ করতে সাহায্য করে। এটি এআই দলগুলোকে তাদের ডেটা ও মেট্রিক্সে কীসের অভাব রয়েছে, তা বোঝানোর জন্য একটি শব্দভাণ্ডার প্রদান করে ।
৫. সোশিওফোনেটিক লেন্স ব্যবহার করে স্পিচ ডেটা ডিজাইন করা
বেশিরভাগ প্রতিষ্ঠান ইতিমধ্যেই ভাষা কভারেজ সম্পর্কে চিন্তা করে ("আমরা ইংরেজি, স্প্যানিশ, হিন্দি সমর্থন করি...")। সমাজবিজ্ঞান আপনাকে আরও গভীরে যেতে উৎসাহিত করে:
৫.১ আপনার সমাজ-ধ্বনিগত "মহাবিশ্ব" মানচিত্র তৈরি করুন
তালিকা দিয়ে শুরু করুন:
- লক্ষ্য বাজার এবং অঞ্চল (উদাহরণস্বরূপ, মার্কিন যুক্তরাষ্ট্র, যুক্তরাজ্য, ভারত, নাইজেরিয়া)।
- চাবি প্রতিটি ভাষার মধ্যে বৈচিত্র্য (আঞ্চলিক উপভাষা, জাতিগত, সমাজতান্ত্রিক)।
- ব্যবহারকারীর গুরুত্বপূর্ণ অংশ: বয়সসীমা, লিঙ্গ বৈচিত্র্য, গ্রামীণ/শহুরে, পেশাদার ক্ষেত্র।
এটি তোমার সমাজ-ধ্বনিগত মহাবিশ্ব — কণ্ঠস্বরের সেই স্থান যেখানে তুমি তোমার সিস্টেমকে পরিবেশন করতে চাও।
৫.২ সেই মহাবিশ্বকে প্রতিফলিত করে এমন বক্তৃতা সংগ্রহ করুন
একবার আপনি আপনার লক্ষ্য স্থানটি জেনে গেলে, আপনি এটির চারপাশে ডেটা সংগ্রহ ডিজাইন করতে পারেন:
- বিভিন্ন জায়গায় বক্তা নিয়োগ করুন অঞ্চল, বয়স গোষ্ঠী, লিঙ্গ এবং সম্প্রদায়.
- একাধিক চ্যানেল ক্যাপচার করুন (মোবাইল, দূর-ক্ষেত্রের মাইক্রোফোন, টেলিফোনি)।
- উভয়ই অন্তর্ভুক্ত করুন পড়া বক্তৃতা এবং প্রাকৃতিক গতি, ছন্দ এবং শৈলীতে বাস্তব জগতের বৈচিত্র্যকে সামনে আনার জন্য কথোপকথন।
শাইপ-এর স্পিচ ও অডিও ডেটাসেট এবং স্পিচ ডেটা সংগ্রহের পরিষেবাগুলো ঠিক এই কাজটি করার জন্যই তৈরি করা হয়েছে — ১৫০টিরও বেশি ভাষার উপভাষা, স্বর এবং উচ্চারণভঙ্গিকে লক্ষ্য করে।
৫.৩ শুধু শব্দ নয়, সোসিওফোনেটিক মেটাডেটা টীকা করুন
শুধুমাত্র একটি প্রতিলিপি থেকে বোঝা যায় না কে কথা বলছে বা তাদের কণ্ঠস্বর কেমন ।
আপনার ডেটাকে সমাজবিজ্ঞান-সচেতন করতে, আপনি যোগ করতে পারেন:
- স্পিকার-স্তরের মেটাডেটা: অঞ্চল, স্ব-বর্ণিত উচ্চারণ, প্রভাবশালী ভাষা, বয়সের ধরণ।
- উচ্চারণ-স্তরের লেবেল: বক্তৃতা শৈলী (ক্যাজুয়াল বনাম আনুষ্ঠানিক), চ্যানেল, ব্যাকগ্রাউন্ড নয়েজ।
- বিশেষায়িত কাজের জন্য, সংকীর্ণ pহোনেটিক লেবেল বা প্রোসোডিক টীকা.
এই মেটাডেটা আপনাকে পরবর্তীতে শুধু সামগ্রিকভাবেই নয়, সামাজিক এবং ধ্বনিগত বিভাগ অনুযায়ীও কর্মক্ষমতা বিশ্লেষণ করতে সাহায্য করে।
৬. সমাজ-ধ্বনিবিদ্যা এবং মডেল মূল্যায়ন: একটি একক WER-এর বাইরে
বেশিরভাগ দল প্রতিটি ভাষার জন্য একটিমাত্র WER (শব্দ ভুলের হার) বা MOS (গড় মতামত স্কোর) প্রকাশ করে। সমাজধ্বনিবিজ্ঞান বলে যে, তা যথেষ্ট নয়।
তোমাকে জিজ্ঞাসা করতে হবে:
- WER কীভাবে পরিবর্তিত হয় উচ্চারণ অনুসারে?
- কিছু বয়স বা অঞ্চল কি ধারাবাহিকভাবে খারাপ অবস্থায় রয়েছে?
- কিছু কণ্ঠের কাছে কি TTS "অন্যদের তুলনায় বেশি স্বাভাবিক" শোনায়?
একটি উচ্চারিত ASR জরিপ তুলে ধরেছে যে উপভাষা এবং উচ্চারণভেদে - এমনকি একটি একক ভাষার মধ্যেও - পারফরম্যান্স কতটা ভিন্ন হতে পারে।
একটি সহজ কিন্তু শক্তিশালী পরিবর্তন হল:
- নির্মাণ করা উচ্চারণ, অঞ্চল এবং মূল জনসংখ্যার ভিত্তিতে স্তরবদ্ধ পরীক্ষার সেট.
- মেট্রিক্স রিপোর্ট করুন উচ্চারণ অনুসারে এবং প্রতি সমাজ-ধ্বনিগত গোষ্ঠীতে.
- বৃহৎ বৈষম্যকে কেবল প্রযুক্তিগত কৌতূহল নয়, প্রথম শ্রেণীর পণ্যের ত্রুটি হিসেবে বিবেচনা করুন।
হঠাৎ করেই, সমাজবিজ্ঞান কেবল তত্ত্ব নয় - এটি আপনার ড্যাশবোর্ডে রয়েছে।
স্পিচ রিকগনিশন ডেটার পরিকল্পনা ও মূল্যায়ন সম্পর্কে আরও বিস্তারিত জানতে, শাইপের ' স্পিচ রিকগনিশনের জন্য প্রশিক্ষণ ডেটা' বিষয়ক নির্দেশিকাটিতে ধাপে ধাপে দেখানো হয়েছে কীভাবে বাস্তব ব্যবহারকারীদের প্রতিফলন ঘটিয়ে ডেটাসেট এবং মূল্যায়ন বিভাজন ডিজাইন করতে হয়।
৭. কেস স্টাডি: উন্নত তথ্যের সাহায্যে অ্যাকসেন্ট পক্ষপাত ঠিক করা
একটি ফিনটেক কোম্পানি একটি ইংরেজি ভাষার ভয়েস অ্যাসিস্ট্যান্ট চালু করেছে। ব্যবহারকারীর পরীক্ষায়, সবকিছু ঠিকঠাক দেখাচ্ছে। লঞ্চের পর, একটি অঞ্চলে সাপোর্ট টিকিটের সংখ্যা বৃদ্ধি পায়। যখন দলটি অনুসন্ধান করে, তারা দেখতে পায়:
- নির্দিষ্ট আঞ্চলিক উচ্চারণের ব্যবহারকারীরা অনেক বেশি ত্রুটির হার দেখতে পাচ্ছেন।
- ASR তাদের স্বরবর্ণ ব্যবস্থা এবং ছন্দের সাথে লড়াই করে, যার ফলে ভুলভাবে স্বীকৃত অ্যাকাউন্ট নম্বর এবং কমান্ড তৈরি হয়।
- প্রশিক্ষণ সেটে সেই অঞ্চলের খুব কম বক্তা রয়েছেন।
সমাজ-ধ্বনিগত দৃষ্টিকোণ থেকে, এটি মোটেও আশ্চর্যজনক নয়: মডেলটিকে কখনই সেই উচ্চারণ শিখতে বলা হয়নি।
দলটি কীভাবে এটি ঠিক করে তা এখানে:
এর ফলস্বরূপ: ঐ অঞ্চলে ভুলের সংখ্যায় পরিমাপযোগ্য হ্রাস, ব্যবহারকারী সন্তুষ্টির উন্নততর স্কোর, এবং এই সুস্পষ্ট অভ্যন্তরীণ উপলব্ধি যে সমাজ-ধ্বনিতাত্ত্বিক পরিধি একটি পণ্যের আবশ্যিক শর্ত , কোনো ঐচ্ছিক বিষয় নয়।
৮. শাইপ কীভাবে সমাজ-ধ্বনিবিদ্যাকে কার্যকরী করতে সাহায্য করে
সমাজ-ধ্বনিগত অন্তর্দৃষ্টিকে উৎপাদন ব্যবস্থায় রূপান্তরিত করার জন্য তিনটি জিনিসের প্রয়োজন:
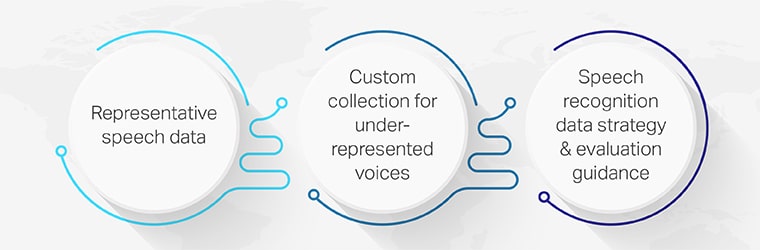
- প্রতিনিধিত্বমূলক বক্তৃতা তথ্য: শাইপ বৃহৎ পরিসরে অফার করে স্পিচ এবং অডিও ডেটাসেট যেটিতে ইতিমধ্যেই ভাষা, উপভাষা এবং রেকর্ডিং অবস্থার মিশ্রণ রয়েছে - সমাজ-ধ্বনিগত প্রস্থের জন্য একটি শক্তিশালী সূচনা বিন্দু।
- কম প্রতিনিধিত্বকারী কণ্ঠস্বরের জন্য কাস্টম সংগ্রহ: উচ্চারণ, সমাজতন্ত্র, অথবা অফ-দ্য-শেল্ফ ডেটা থেকে অনুপস্থিত সম্প্রদায়ের জন্য, Shaip's বক্তৃতা তথ্য সংগ্রহ পরিষেবা আপনার মডেলদের প্রয়োজনীয় স্কেলে সঠিক স্পিকার, চ্যানেল এবং দৃশ্যকল্প নিয়োগ এবং রেকর্ড করতে পারে।
- বক্তৃতা স্বীকৃতি ডেটা কৌশল এবং মূল্যায়ন নির্দেশিকা: শাইপের মতো গাইড স্পিচ রিকগনিশন ডেটাসেট নির্বাচন এবং প্রশিক্ষণ-ডেটা প্লেবুকগুলি দলগুলিকে ডেটাসেট এবং পরীক্ষার সেট পরিকল্পনা করতে সাহায্য করে যা কেবল ভাষার লেবেল নয়, বাস্তব সামাজিক-ধ্বনিগত পরিবর্তনের সাথে সামঞ্জস্যপূর্ণ।
যখন আপনি সমাজধ্বনিবিজ্ঞানকে এই ধরনের ডেটা এবং মূল্যায়ন পরিকাঠামোর সাথে একত্রিত করেন , তখন আপনি এই অবস্থা থেকে সরে আসেন:
"আমরা ইংরেজি সমর্থন করি।" প্রতি:
"আমরা আমাদের ব্যবহারকারীদের দ্বারা বাস্তবে কথ্য ইংরেজি সমর্থন করি - অঞ্চল, উচ্চারণ এবং সম্প্রদায় জুড়ে - এবং আমরা আমাদের মেট্রিক্সে এটি প্রমাণ করতে পারি।"