আপনার ভয়েস মডেলটি ডেমোতে চমৎকার কাজ করে। কিন্তু যখন এটি একজন আসল ব্যবহারকারীর সংস্পর্শে আসে—যেমন স্কটিশ উচ্চারণের কেউ, যিনি চলন্ত গাড়ি থেকে হিংলিশে অর্ডার দিচ্ছেন—তখন ট্রান্সক্রিপ্টটি পুরোপুরি ভেস্তে যায়।
২০২৬ সালের ভয়েস এআই-এর অস্বস্তিকর সত্যটি হলো: মডেলগুলো আর্কিটেকচার ভুল হওয়ার কারণে ব্যর্থ হয় না। এগুলো ব্যর্থ হয় কারণ ডেটাসেটটি কখনোই বিশ্বের সব ভাষায় কথা বলেনি। আপনার ভয়েস মডেল ততক্ষণ পর্যন্ত স্কেল করবে না, যতক্ষণ না আপনার ট্রেনিং ডেটা স্কেল করে — আর একারণেই বহুভাষিক স্পিচ ডেটা আজকের এআই-এর অন্যতম কৌশলগত সম্পদে পরিণত হয়েছে।

বাস্তব পরিস্থিতিতে কেন বেশিরভাগ ভয়েস এআই মডেল ব্যর্থ হয়
বাস্তব জগতের ভয়েস এআই ব্যর্থতার সিংহভাগের জন্যই পাঁচটি প্রতিবন্ধকতা দায়ী — এবং লক্ষণীয় যে, প্রতি ১০টি স্পিচ মডেলের মধ্যে প্রায় ৭টিই তাদের প্রশিক্ষণ ডেটার ভাষাগত বৈচিত্র্যের ঘাটতির কারণে ব্যর্থ হয়।
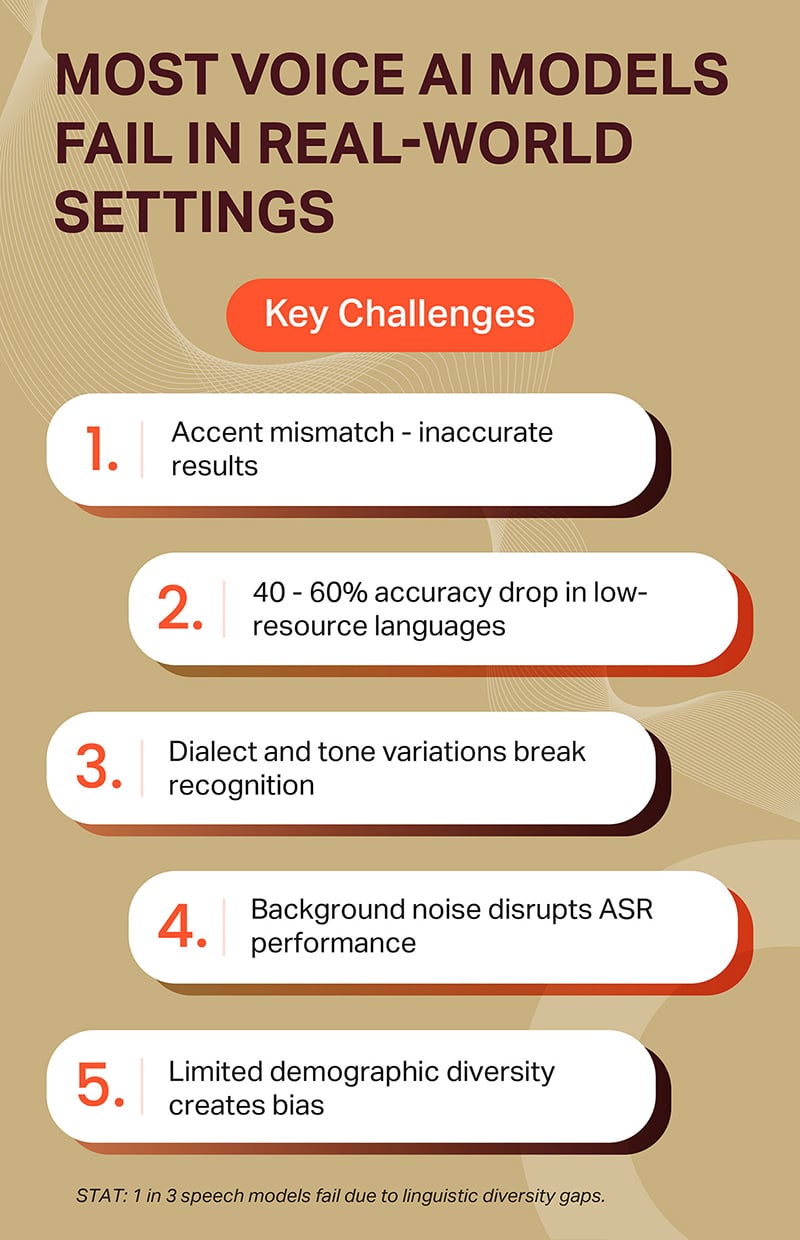
উচ্চারণের অমিলই প্রথম বিষয়: মূলত আমেরিকান ইংরেজির ওপর প্রশিক্ষিত একটি মডেল, একই শব্দ ভিন্ন স্বরবর্ণে শোনার সাথে সাথেই ভুল ফলাফল দেয়।
স্বল্প-সম্পদশালী ভাষাগুলো আরও বেশি ক্ষতিগ্রস্ত হয় — যখন কোনো মডেল এমন একটি ভাষার সম্মুখীন হয় যার প্রশিক্ষণ ডেটা কম ছিল, তখন তার নির্ভুলতা ৪০-৬০% পর্যন্ত কমে যাওয়া সাধারণ ঘটনা।
উপভাষা ও স্বরের ভিন্নতার কারণে একই ভাষার মধ্যেও চেনা কঠিন হয়ে যায়; “ইংরেজি” যেমন একটি ভাষা নয়, তেমনি আরবি, স্প্যানিশ বা ম্যান্ডারিনও নয়।
পারিপার্শ্বিক কোলাহল —যেমন যানবাহনের চলাচল, রান্নাঘর, কল-সেন্টারের কথাবার্তা—ঠিক সেই পরিবেশেই ASR-এর কার্যকারিতা ব্যাহত করে, যেখানে ভয়েস ইন্টারফেস সবচেয়ে বেশি কার্যকর।
এবং প্রশিক্ষণ ডেটাতে সীমিত জনতাত্ত্বিক বৈচিত্র্য পক্ষপাত তৈরি করে: এমন মডেল তৈরি হয় যা তরুণ শহুরে বক্তাদের কথা ভালোভাবে শুনতে পায়, কিন্তু বয়স্ক বা গ্রামীণ বক্তাদের কথা ভালোভাবে শুনতে পায় না।
এগুলোর কোনোটিই মডেল সমস্যা নয়। সবগুলোই ডেটা সমস্যা।
এআই-কে অবশ্যই বাস্তব পরিস্থিতিতে বাস্তব মানুষদের বুঝতে হবে।
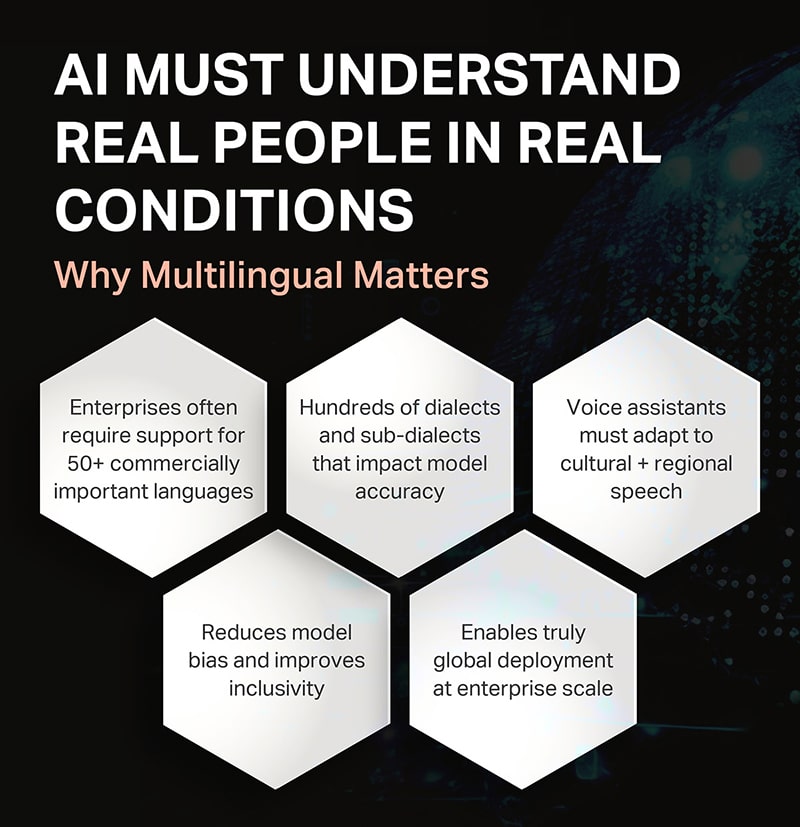
এন্টারপ্রাইজ পর্যায়ে বহুভাষিক ডেটা এত গুরুত্বপূর্ণ কেন? কারণ, সমস্যাটির ব্যাপ্তি বেশিরভাগ দলের ধারণার চেয়েও বড়।
প্রতিষ্ঠানগুলোর নিয়মিতভাবে ৫০টিরও বেশি বাণিজ্যিকভাবে গুরুত্বপূর্ণ ভাষার জন্য সমর্থনের প্রয়োজন হয় — এবং এই ভাষাগুলোর নিচে রয়েছে শত শত উপভাষা ও উপ-উপভাষা, যা মডেলের নির্ভুলতাকে সরাসরি প্রভাবিত করে। ভয়েস অ্যাসিস্ট্যান্টদের শুধু শব্দভান্ডারের সাথেই নয়, বরং সাংস্কৃতিক ও আঞ্চলিক কথ্য ভাষার সাথেও খাপ খাইয়ে নিতে হয় : যেমন কথার গতি, সৌজন্য প্রকাশের ধরণ এবং কোড-সুইচিং। এই বিষয়টি সঠিকভাবে করতে পারলে মডেলের পক্ষপাতিত্ব কমে এবং অন্তর্ভুক্তিমূলকতা বাড়ে — ভয়েস এআই দ্বারা প্রায়শই যেসব ব্যবহারকারী বঞ্চিত হন, তারা ইতিমধ্যেই পর্যাপ্ত সেবা থেকে বঞ্চিত। এবং পরিশেষে, এই বৈচিত্র্যময় কথ্য ভাষার ডেটাই এন্টারপ্রাইজ পর্যায়ে সত্যিকারের বিশ্বব্যাপী প্রয়োগকে সম্ভব করে তোলে : এমন একটি পণ্য যা মুম্বাই, মেক্সিকো সিটি এবং ম্যানচেস্টার—সবখানেই সমানভাবে কাজ করে।
বহুভাষিক বক্তৃতা ডেটাসেট ডিএনএ: একটি শক্তিশালী ডেটাসেট কী কী বিষয় অন্তর্ভুক্ত করে
তাহলে বিশ্বমানের স্পিচ ডেটা আসলে দেখতে কেমন? ছয়টি ডাইমেনশন — এগুলোকে ডেটাসেটের ডিএনএ হিসেবে ভাবুন।
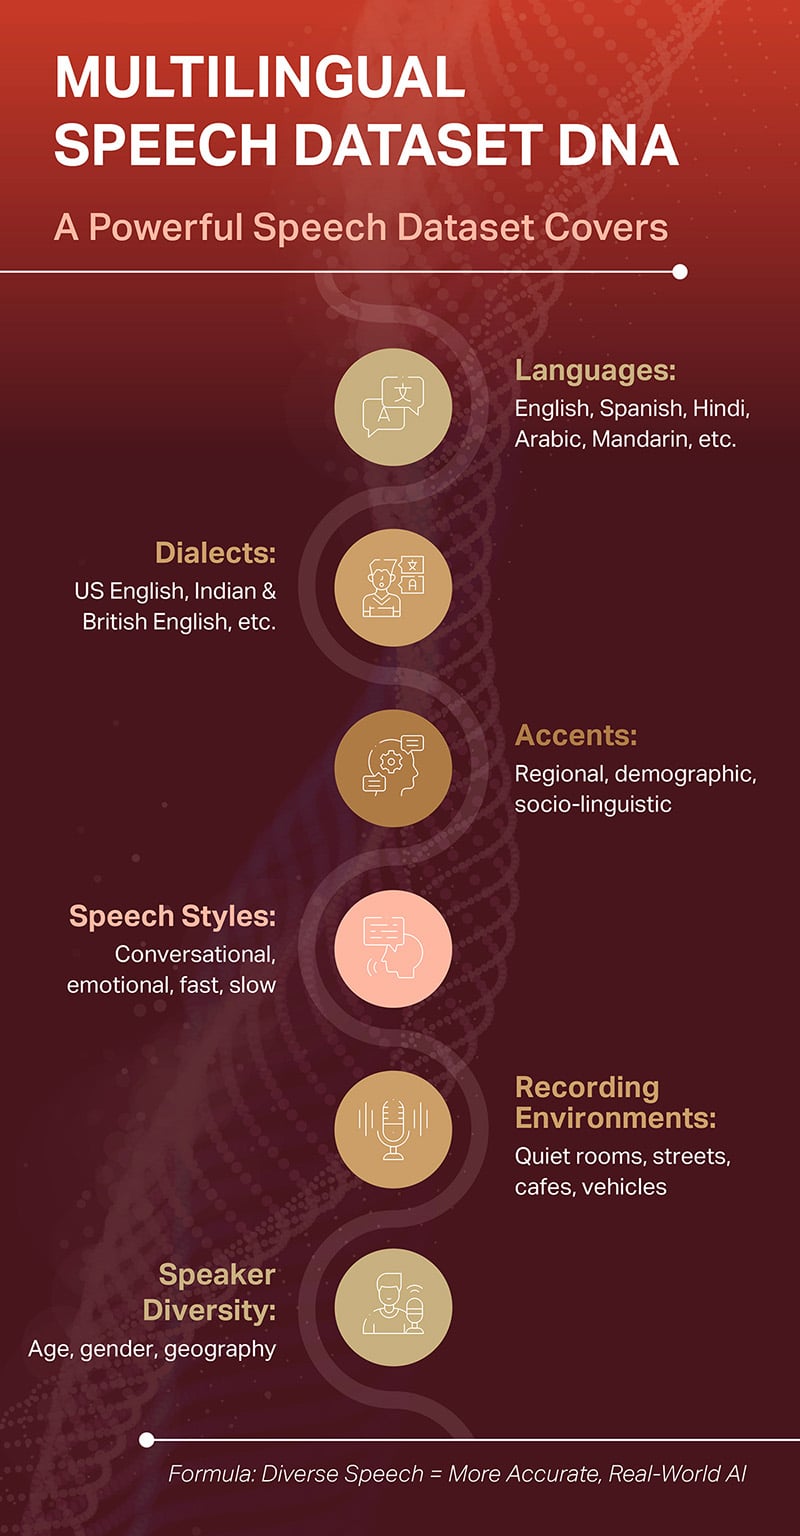
ভাষা: ইংরেজি, স্প্যানিশ, হিন্দি, আরবি, ম্যান্ডারিন এবং আরও অনেক ভাষা জুড়ে বিস্তৃত পরিসর।
উপভাষা: মার্কিন, ভারতীয় এবং ব্রিটিশ ইংরেজির মতো স্বতন্ত্র রূপগুলোকে তাদের নিজস্ব পরিচয়েই বিবেচনা করা হয় — এগুলো ভিন্ন ভিন্ন কথ্য ভাষারীতি, কোনো একটি নির্দিষ্ট শ্রেণিতে পড়ে না।
উচ্চারণভঙ্গি: প্রতিটি উপভাষার মধ্যে আঞ্চলিক, জনতাত্ত্বিক এবং সমাজ-ভাষাগত ভিন্নতা।
কথা বলার ধরণ: কথোপকথনমূলক, আবেগপূর্ণ, দ্রুত, ধীর — কারণ কেউই স্ক্রিপ্ট পড়ার মতো করে ভয়েস অ্যাসিস্ট্যান্টের সাথে কথা বলে না।
রেকর্ডিংয়ের পরিবেশ: শান্ত ঘর, রাস্তা, ক্যাফে, যানবাহন — বাস্তব জীবনের ধ্বনিগত পরিস্থিতি।
বক্তাদের বৈচিত্র্য: বয়স, লিঙ্গ এবং ভৌগোলিক অবস্থান নির্বিশেষে সুষম উপস্থিতি।
সূত্রটি সহজ: বৈচিত্র্যময় বক্তব্য = আরও নির্ভুল, বাস্তবসম্মত এআই। আপনি প্রতিটি দিক এড়িয়ে গেলেই তা এমন একটি ব্যবহারকারী গোষ্ঠীতে পরিণত হয়, যার জন্য আপনার পণ্য ব্যর্থ হয়।
যেখানে বহুভাষিক স্পিচ এআই কার্যকর: এন্টারপ্রাইজ ব্যবহারের ক্ষেত্রসমূহ
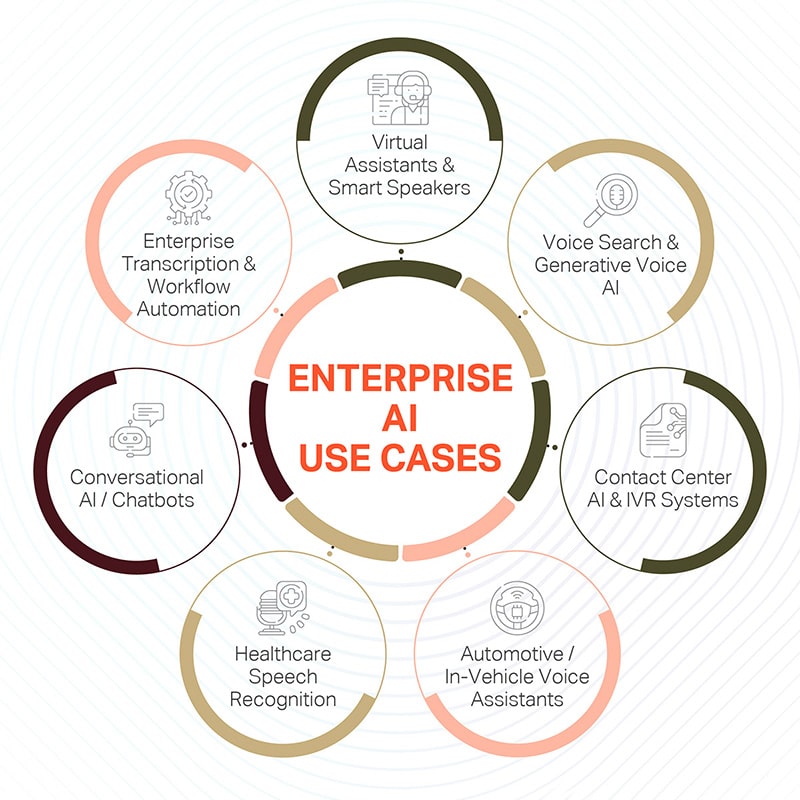
এই অ্যাপ্লিকেশনগুলো প্রায় প্রতিটি শিল্পক্ষেত্রে বিস্তৃত যেখানে মানুষ যন্ত্রের সাথে কথা বলে: ভার্চুয়াল অ্যাসিস্ট্যান্ট ও স্মার্ট স্পিকার; ভয়েস সার্চ; এন্টারপ্রাইজ ট্রান্সক্রিপশন ও ওয়ার্কফ্লো অটোমেশন; কনভারসেশনাল এআই ও চ্যাটবট; কন্টাক্ট সেন্টার এআই ও আইভিআর সিস্টেম; স্বাস্থ্যসেবায় স্পিচ রিকগনিশন, যেখানে নির্ভুলতা সরাসরি সেবাকে প্রভাবিত করে; এবং গাড়ির ভেতরের ভয়েস অ্যাসিস্ট্যান্ট, যেখানে কোলাহল ও উচ্চারণের ভিন্নতা একই কঠিন পরিবেশে একসাথে মিশে যায়।
এই সবগুলোর ক্ষেত্রেই, ব্যবহারকারীর অভিজ্ঞতার সর্বোচ্চ সীমা মডেলটি নয় — বরং মডেলটি বিশ্বের কতটুকু ভাষা আসলে শুনেছে, সেটাই আসল বিষয়।
শাইপ কীভাবে বিশ্বমানের স্পিচ এআই সক্ষম করে
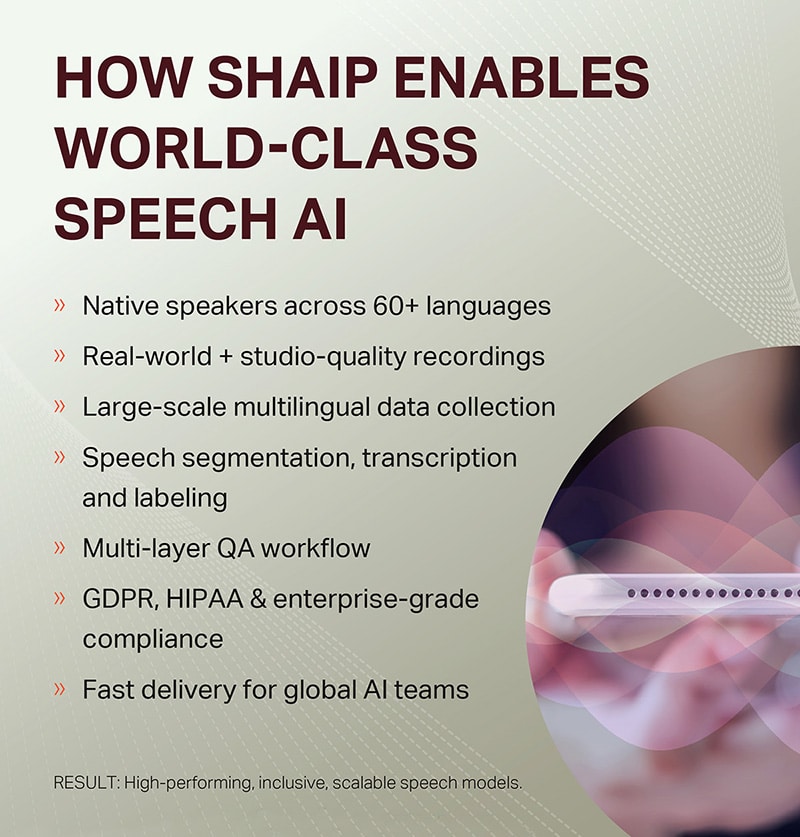
ভাষাগত বৈচিত্র্যের ব্যবধান পূরণ করতে শুধু অডিও স্ক্র্যাপিং-ই যথেষ্ট নয় — এর জন্য প্রয়োজন সুচিন্তিত ও মান-নিয়ন্ত্রিত ডেটা অপারেশন। এখানেই শাইপ-এর ভূমিকা: ৬০টিরও বেশি ভাষার নেটিভ স্পিকার; বাস্তব ও স্টুডিও-মানের রেকর্ডিং; বৃহৎ পরিসরে বহুভাষিক ডেটা সংগ্রহ; স্পিচ সেগমেন্টেশন, ট্রান্সক্রিপশন এবং লেবেলিং; একটি বহুস্তরীয় QA ওয়ার্কফ্লো; GDPR, HIPAA এবং এন্টারপ্রাইজ-গ্রেড কমপ্লায়েন্স; এবং বিশ্বব্যাপী AI টিমগুলোর জন্য দ্রুত ডেলিভারি।
এর ফলে এমন প্রশিক্ষণ ডেটা পাওয়া যায় যা আপনার পণ্যটি প্রকৃতপক্ষে যাদের সেবা দেবে, তাদেরই প্রতিফলিত করে — শুধু তাদের নয় যাদের তথ্য রেকর্ড করা সবচেয়ে সহজ।
তলদেশের সরুরেখা
ভয়েস এআই নতুনত্বের গণ্ডি পেরিয়ে অবকাঠামোতে পরিণত হয়েছে, কিন্তু এর সবচেয়ে বড় ব্যর্থতাগুলোর মূল কারণ এখনও একটাই: ডেটাসেট যা বাস্তব জগতের মতো শোনায় না। উচ্চারণভঙ্গি, উপভাষা, কোলাহল এবং জনসংখ্যার বৈচিত্র্য কোনো বিচ্ছিন্ন ঘটনা নয় — এগুলোই হলো প্রয়োগের পরিবেশ।
এমন ভয়েস এআই তৈরি করুন যা বিশ্বকে বোঝে, এবং ব্যর্থতার উৎস যেখানে, সেখান থেকেই শুরু করুন: ডেটা।